LTX-2.5 能生成 41 秒,但那 41 秒剪不动
目录 · 12 节
LTX-2.5 是 Lightricks 2026-08-11 开源的视频生成模型,一次前向同时出画面和立体声,开源当天 ComfyUI 就给了原生支持。它比上一代多出来的招牌能力叫 multishot:一次生成出好几个用硬切连起来的镜头,跨切保持人物、环境、灯光和声音。
我在 AutoDL 租的 RTX PRO 6000(96 GB 显存)上,从装机跑到出片。这篇只讲其中一件事:它到底能做多长。
两句话的结论。LTX 自己卖的托管 API 最长给 20 秒,它开源出来的权重,在自己的卡上跑到了 41 秒。但那 41 秒是一个长镜头,多镜头只在 15 秒以内成立。
先把这篇的边界划清楚
全部是官方模板参数,一个没调。没上 dev 权重、没装 SageAttention、没换采样器、没动步数和 CFG。所以这篇只谈时长和剪辑,不谈画质高低——画质要比,得两边都往上调一档再说,那是另一篇。
唯一一处偏离默认:官方模板自带的提示词改写器我关掉了。它默认开着,会把你写的东西重写一遍(第六节第二条有它的坑)。要测 multishot 是模型的能力还是改写器的功劳,就得关掉它。
下面所有片子都是同一台机器、同一个 ComfyUI 0.32.0。
一、按官方那套写法,它是真的能剪
官方的多镜头规范在 docs.ltx.io 的 prompting guide 里。注意 docs.ltx.video 那个域名对外 403,同一份文档,只有前一个能打开。
规范要求每个切口做四件事:点名那个切(A hard cut transitions to…、The view cuts to…、A match cut connects…)、重新确立这一镜的景别机位和谁在画面里、重复同一批可视标识做身份重锚、写明声音跨切延续,比如 the synth score continues across the cut。外加两条:一次 2 到 4 镜;以及 Avoid conflicting geography,别在一条提示词里描述互相冲突的空间。
只罗列 A medium shot… A close-up… A wide shot… 是一定不会切的。官方写明这属于 shot list,除非你同时在散文里描述那个切。
下面三条:同一条提示词、同一块画布 1344×768、同一个 seed,只有时长不同。
5 秒
两刀切在 1.42 秒和 3.42 秒。中景 → 特写 → 低角度大全景,三镜各约 1.7 秒
10 秒
同一条提示词拉到 10 秒,两刀落在 2.92 秒和 6.54 秒,节奏自己松开了
15 秒
15 秒这条切得最干净,两刀在 3.92 秒和 10.79 秒,分镜变成 3.9 / 6.9 / 4.2 秒,中间那个特写自己拿到了大头
三条都对。而且跨切之后,灰羊毛大衣、暗红围巾、束起的黑发、纸灯笼的暖光全部对得上,一张参考图都没给。
跨镜头一致性不是靠参考图锁出来的,是几个镜头本来就在同一次生成里长出来的。 这是 multishot 唯一值钱的地方。
二、于是去找它的上限
41 秒、985 帧、1344×768,一次过。总耗时 386 秒,峰值显存 51219 MiB / 97887,才用掉 52%。
没有任何接近极限的迹象。再提一档,42 秒 1009 帧,提交直接被打回来:
Value 1009 bigger than max of 1000 | frames_number这是 ComfyUI 里 LTXVEmptyLatentAudio 的参数校验,frames_number 上限写死 1000。而视频那条链上 EmptyLTXVLatentVideo 的 length 上限是 16384,根本不卡。
卡住时长的只有音频节点。不是模型跑不动,是有个整数框填不进去。
那 41 秒长什么样?提示词写法和上面三条一模一样,四个镜头:
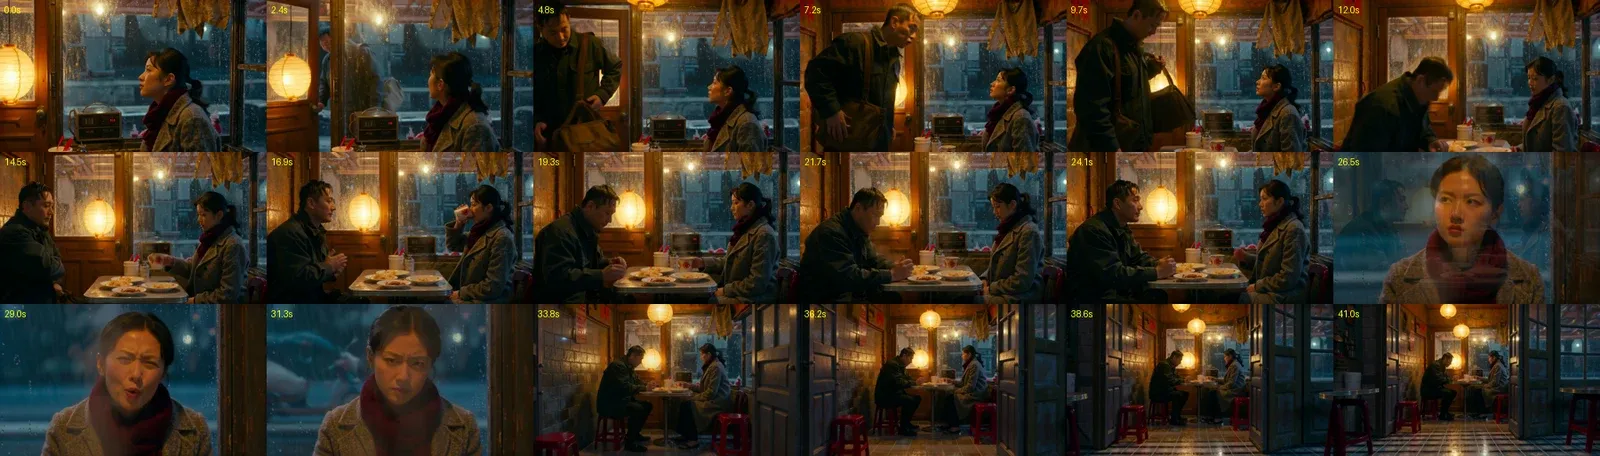
20 帧铺开,一处切口都没有。要求的四个镜头变成了一个长镜头
三、上限等于 1000 除以 fps,但绕过去的那条路是死的
闸门卡的是帧数,而音频时长等于 frames_number ÷ frame_rate。降 fps 就能换更长的片,我按这个跑了一条 60 秒 @16fps,961 帧,技术上完全成立。
然后那东西不能用。16fps 不是任何交付格式。
| fps | 用途 | 可交付的最长时长 |
|---|---|---|
| 24 | 电影标准 | 41.4 秒 |
| 25 | PAL 广播 | 40.0 秒 |
| 30 | 短视频标准 | 33.3 秒 |
| 不是任何交付格式 |
电影一百年来就是 24;抖音、Reels、Shorts 通常 30;动画作画常一拍二每秒 12 张,但输出仍然是 24。16fps 在这张表里没有位置。
绕过限制不等于解决问题。 绕出来的东西还在不在可交付的格式里,得先问一句。
那条 60 秒还崩得很典型:
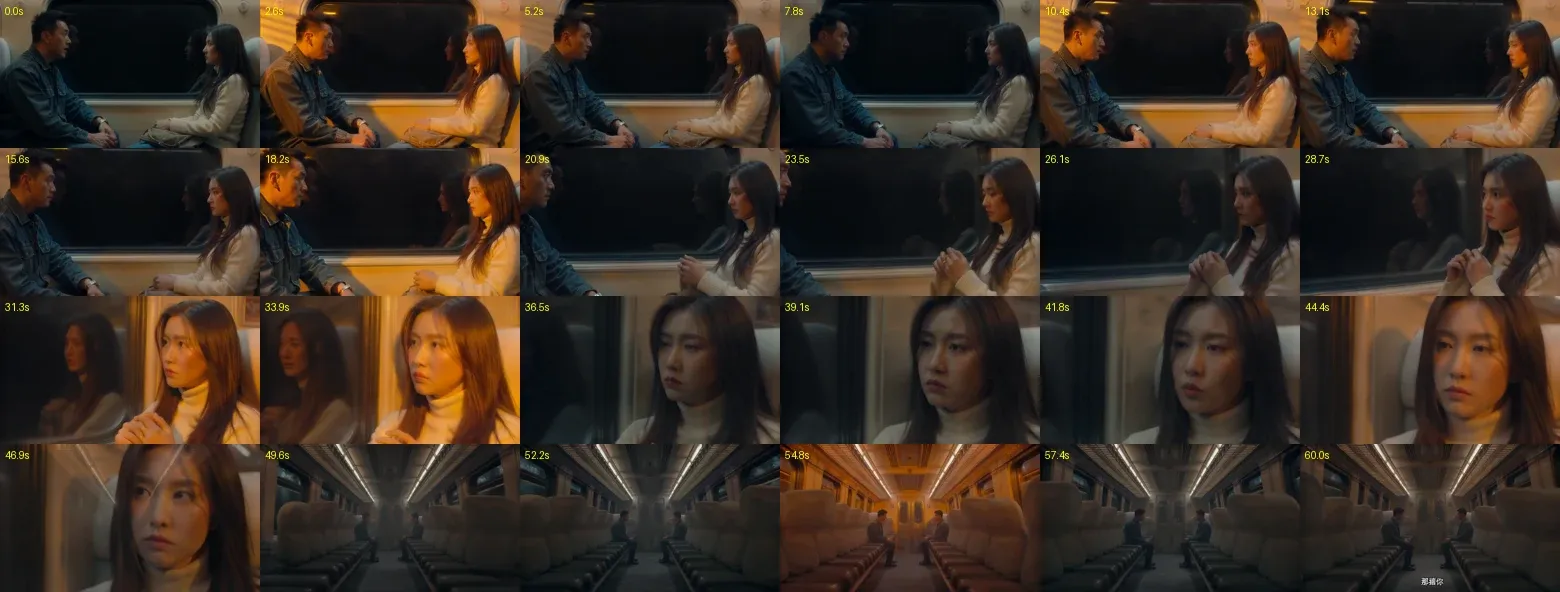
第一镜拖了 30 秒、第二镜 16 秒,画面基本停滞。写给 15 秒的提示词直接拿去撑 60 秒,内容密度掉到四分之一
顺带一条:30fps 下秒数必须是 4 的倍数才满足 LTX 的 帧数 % 8 == 1(s×30+1 ≡ 1 (mod 8) 要求 s ≡ 0 (mod 4))。33 秒非法,最接近的合法值是 32 秒。
四、15 秒能切,32 秒不切,而且不是提示词的问题
把第一节那条阶梯往上加,就是这张图:

纵轴是整条片子里最大的帧间差分,以该片自身均值的倍数计。真正的硬切会在单帧上炸出十几到二十倍的尖峰;4 倍以下基本等于没有
| 时长 | 检出硬切 | 最大信号 |
|---|---|---|
| 5 秒 | 2 个 | 19.4× |
| 10 秒 | 2 个 | 13.7× |
| 15 秒 | 2 个 | 32.4× |
| 32 秒 | 0 个 | 4.0× |
| 41 秒 | 0 个 | 2.7× |
我先给了一个错的解释
第一反应是内容密度不够,提示词里的事件撑不满那么长的片子,模型没东西可拍。上面那条 60 秒的停滞看起来正是这个。
把密度量化一下,用词数除以秒数:
| 密度 | 结果 | |
|---|---|---|
| 15 秒那条 | 15.4 词/秒 | 2 个干净硬切 |
| 41 秒那条 | 8.0 词/秒 | 0 个 |
| 60 秒那条 | 3.9 词/秒 | 崩 |
三个点、方向一致、机制说得通。这就是把相关性当因果的标准长相。
拆开它只需要一条:做一个相关性预测成功、而因果预测失败的组合,也就是高密度加长时长。
我为 32 秒专写了一条:466 词、4 个镜头、6 句台词,14.6 词/秒,几乎追平那条成功的 15 秒。而且严格照官方四条写,每个切口点名、每一镜重新交代景别机位、人物特征反复重锚、声音跨切延续写明、地理零冲突。
结果是 0 个硬切。
所以密度决定有没有东西可拍,时长决定切不切得动。那条 60 秒的停滞确实是密度问题,但切点消失改提示词救不回来。
要注意 15 秒和 32 秒之间没有采样点,拐点具体在哪不知道。要用在生产上,按 15 秒设计是安全的。
五、不是不转场,是转场变软
那 32 秒到底发生了什么:
32 秒、严格遵守官方四条的那一条。镜头是换了的,但第 8 秒和第 16 秒能看到明显的叠影
模型没有拒绝转场,它把要求的硬切做成了溶接。这也解释了为什么自动检测抓不到:溶接是渐变,差分曲线上是一段缓坡,不是一根针。
所以准确的说法不是长片不转场,而是长片里转场变软。这个区别很实际,溶接在成片里是能用的,只是当你要的是硬切时,你得不到。
六、几个不报错、只是悄悄给你错数据的坑
第一个是 ComfyUI 的节点缓存会伪造出更快。冷启动一条 130.87 秒,不卸载模型再跑一遍同样的提示词和 seed,得到 30.62 秒,看起来是漂亮的加速数据。
但它比更小画布的那条还快,而像素多了 2.77 倍。更大的画布反而更快在物理上不可能,这就是自查的抓手。查 /history 里的 execution_cached,32 个节点直接复用了上一次的输出;换个 seed 强制失效,真值 97.22 秒。所以热跑计时必须换 seed 或改任一输入,并回读 execution_cached 的节点数确认没吃到缓存。
第二个是内置的提示词改写器会安静地吐出空字符串。模板里那个 TextGenerateLTX2Prompt 用 Gemma 把短句扩写成训练 caption 风格,默认是开的。喂一段中文进去,它返回空串,而整条管线不报错,照样拿空提示词生成了一条片,状态 success。
不是抽卡失手:同一条输入在 seed=0 下连跑六次,六次全空;换成 1、42、12345 全都正常。它在固定 seed 下是确定性的,某些输入会被确定性地映射成空。 而 seed=0 正是官方模板的默认值。
它还会把整句台词丢掉,中文对白扩写后消失得干干净净,尽管它自己的系统提示词第 5 条明写着对白必须原语言原样引用。所以官方内置不等于忠实,改写器的输出要校验非空,还要逐条核原来那些要素还在不在。
第三个是分辨率的真实约束是被 64 整除,不是官方说的 32。官方 README 写宽高须被 32 整除,但 ComfyUI 这条管线是两段式的:第一段在 w/2, h/2 上采样,再做 latent 2 倍上采样,而 latent 要求被 32 整除。写 1280×736 出来的是 1280×704,写 864×480 出来的是 832×448,被静默裁掉,不报错。官方那张 16:9 档位表里大部分档位都会被裁,包括模板自己的默认档。
第四个是跨机器的对比要连硬件一起控。我拿这台 RTX PRO 6000 上的数字,去对另一台 RTX 5090 上的另一个模型,控住了画布、时长、帧数,写下逐项可比——两块卡就摆在那儿。那条结论已经作废。
第五个是空间穿帮可能是自己写出来的。有一条 32 秒,前半段两人面对面坐、中间一张小桌,后半段桌子没了、人变成并排。看起来像模型在长片里的空间漂移,其实是一条提示词里塞了两种车厢:镜 1 写面对面的卡座,镜 4 写沿着过道推进、越过一排排空座椅。正是官方那条 Avoid conflicting geography。地理统一之后,那张桌子全程都在。
这条还暴露了检查本身的缺口:帧间差分查得出切点,查不出桌子没了;事件清单每项都打勾,也查不出空间关系已经变了。得单加一项,跨镜抽帧比对座位关系、关键道具、人物相对位置。
该问的不是能生成多长
41 秒这个数是真的:跑得通、显存只用一半、上限还是被一个节点的整数框卡住的,不是模型的极限。
但它没什么用,因为在 41 秒里你只能拍一个镜头。
真正该问的是:最长多少秒,还剪得动。答案是 15 秒。
要拿它做段落,就按 15 秒设计:2 到 4 个镜头,每个切口写全那四件事,别写超过 15 秒的段落。更长的片子它照样生成,只是那会变成一个长镜头,或者一串软绵绵的溶接。