同一张 5090 上再装一个出图模型
目录 · 13 节
上一篇在一张 RTX 5090 上把 MiniMax H3 跑到了底,那是视频。这次在同一台机器上加一条图片产线。
选型、装机、跑基线,一天做完。这篇记的是为什么是 HiDream-O1、它在这张卡上什么速度,以及一个查了很久才查明白的老问题:ComfyUI 为什么会把自己撑死。
先说结论:出图比出片轻松得多。2048×2048 四百万像素、40 步,42 秒一张,显存只吃四成,而同一张卡跑视频时是 98%。中文 prompt 直接喂就懂,指定的中文招牌一字不差。
一、许可比画质更早把人筛掉
开源出图模型现在很多。我列了四条判据,要同时满足:画质靠前、许可能商用、ComfyUI 原生支持不用装第三方节点、一个模型同时能出图和吃参考图。
第二条淘汰得最狠。
FLUX.2 [dev] 的许可有个容易读反的结构:产出端是放开的,原文写着 You may use Output for any purpose (including for commercial purposes);卡的是模型端,它对非商业用途的定义明确排除了营收活动。也就是说,你自己玩、出的图自己用,可以;但一旦生成这一步进了营收链条,越线的是用模型这件事,不是用图。
Ideogram 4.0 在盲测榜上是开源第一,但权重在 Hugging Face 上是 gated 的,协议还把限制延伸到产出用途。
筛完只剩一个同时满足四条的:HiDream-O1-Image,8B,MIT 许可,文生图和图片编辑两个榜都排第二。
顺带一个坑:Qwen-Image-2.0 不是开源的。一堆二手博客写它 Apache 2.0,但官方仓库的时间线里它只有 Qwen Chat 和 API,没放权重。开源线最新的是 Qwen-Image-2512。
二、中文招牌是准的
这条超出我的预期,所以先放。
上一轮选型时我以为中文字得靠 Qwen-Image-Edit,还写进了方案。实测把这条推翻了。
prompt 里我指定了两块牌子的内容:门楣的木牌刻灯下书局,下面小黑板写营业 九时至十八时。
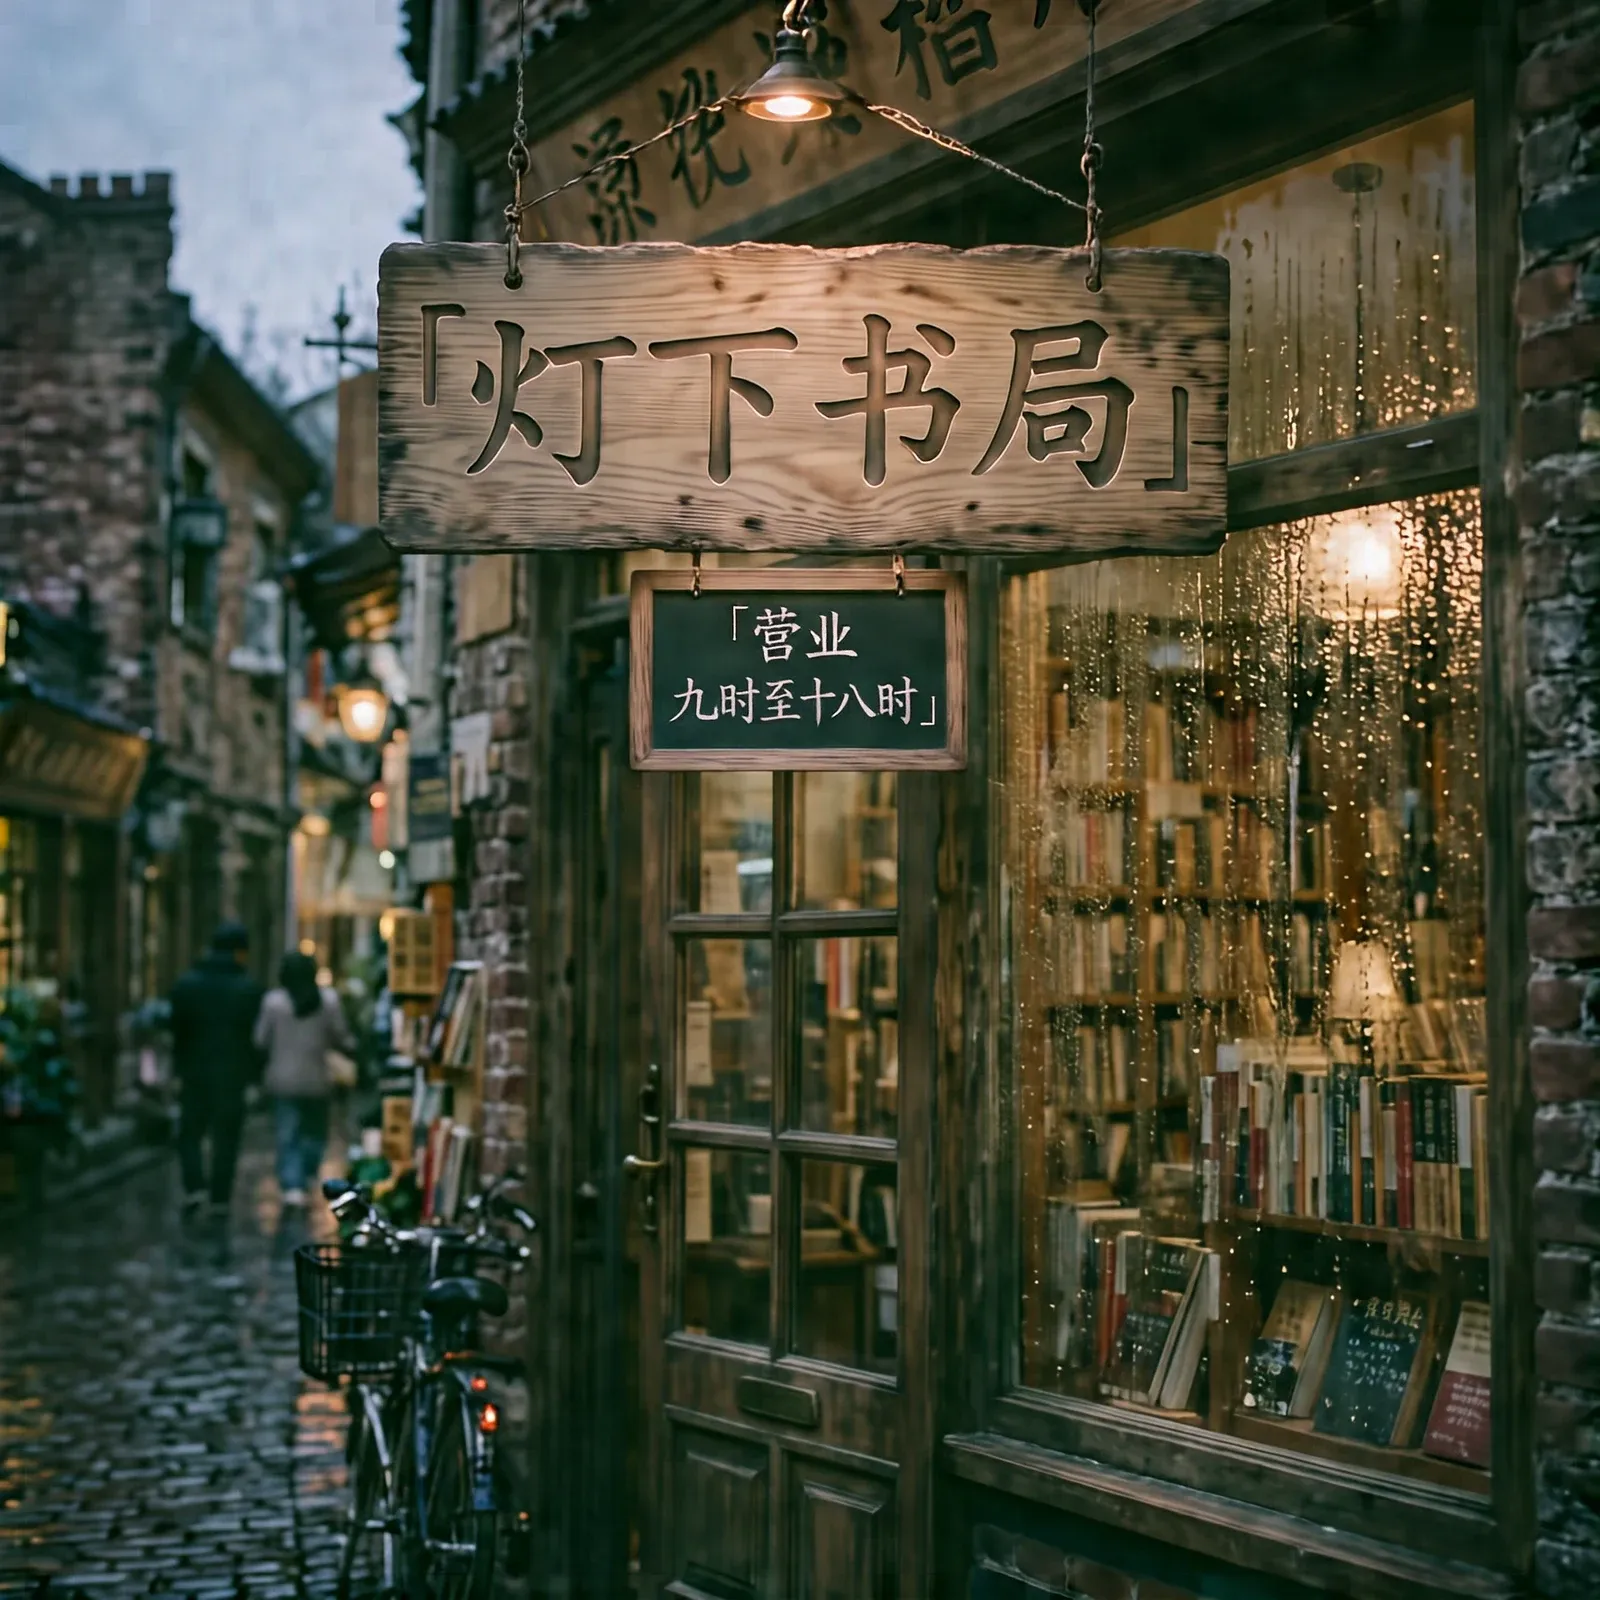
两块牌子的字一字不差,连 prompt 里写的直角引号都照着刻了出来
英文那条同样全对,而且自动分了行、粉笔质感也成立:
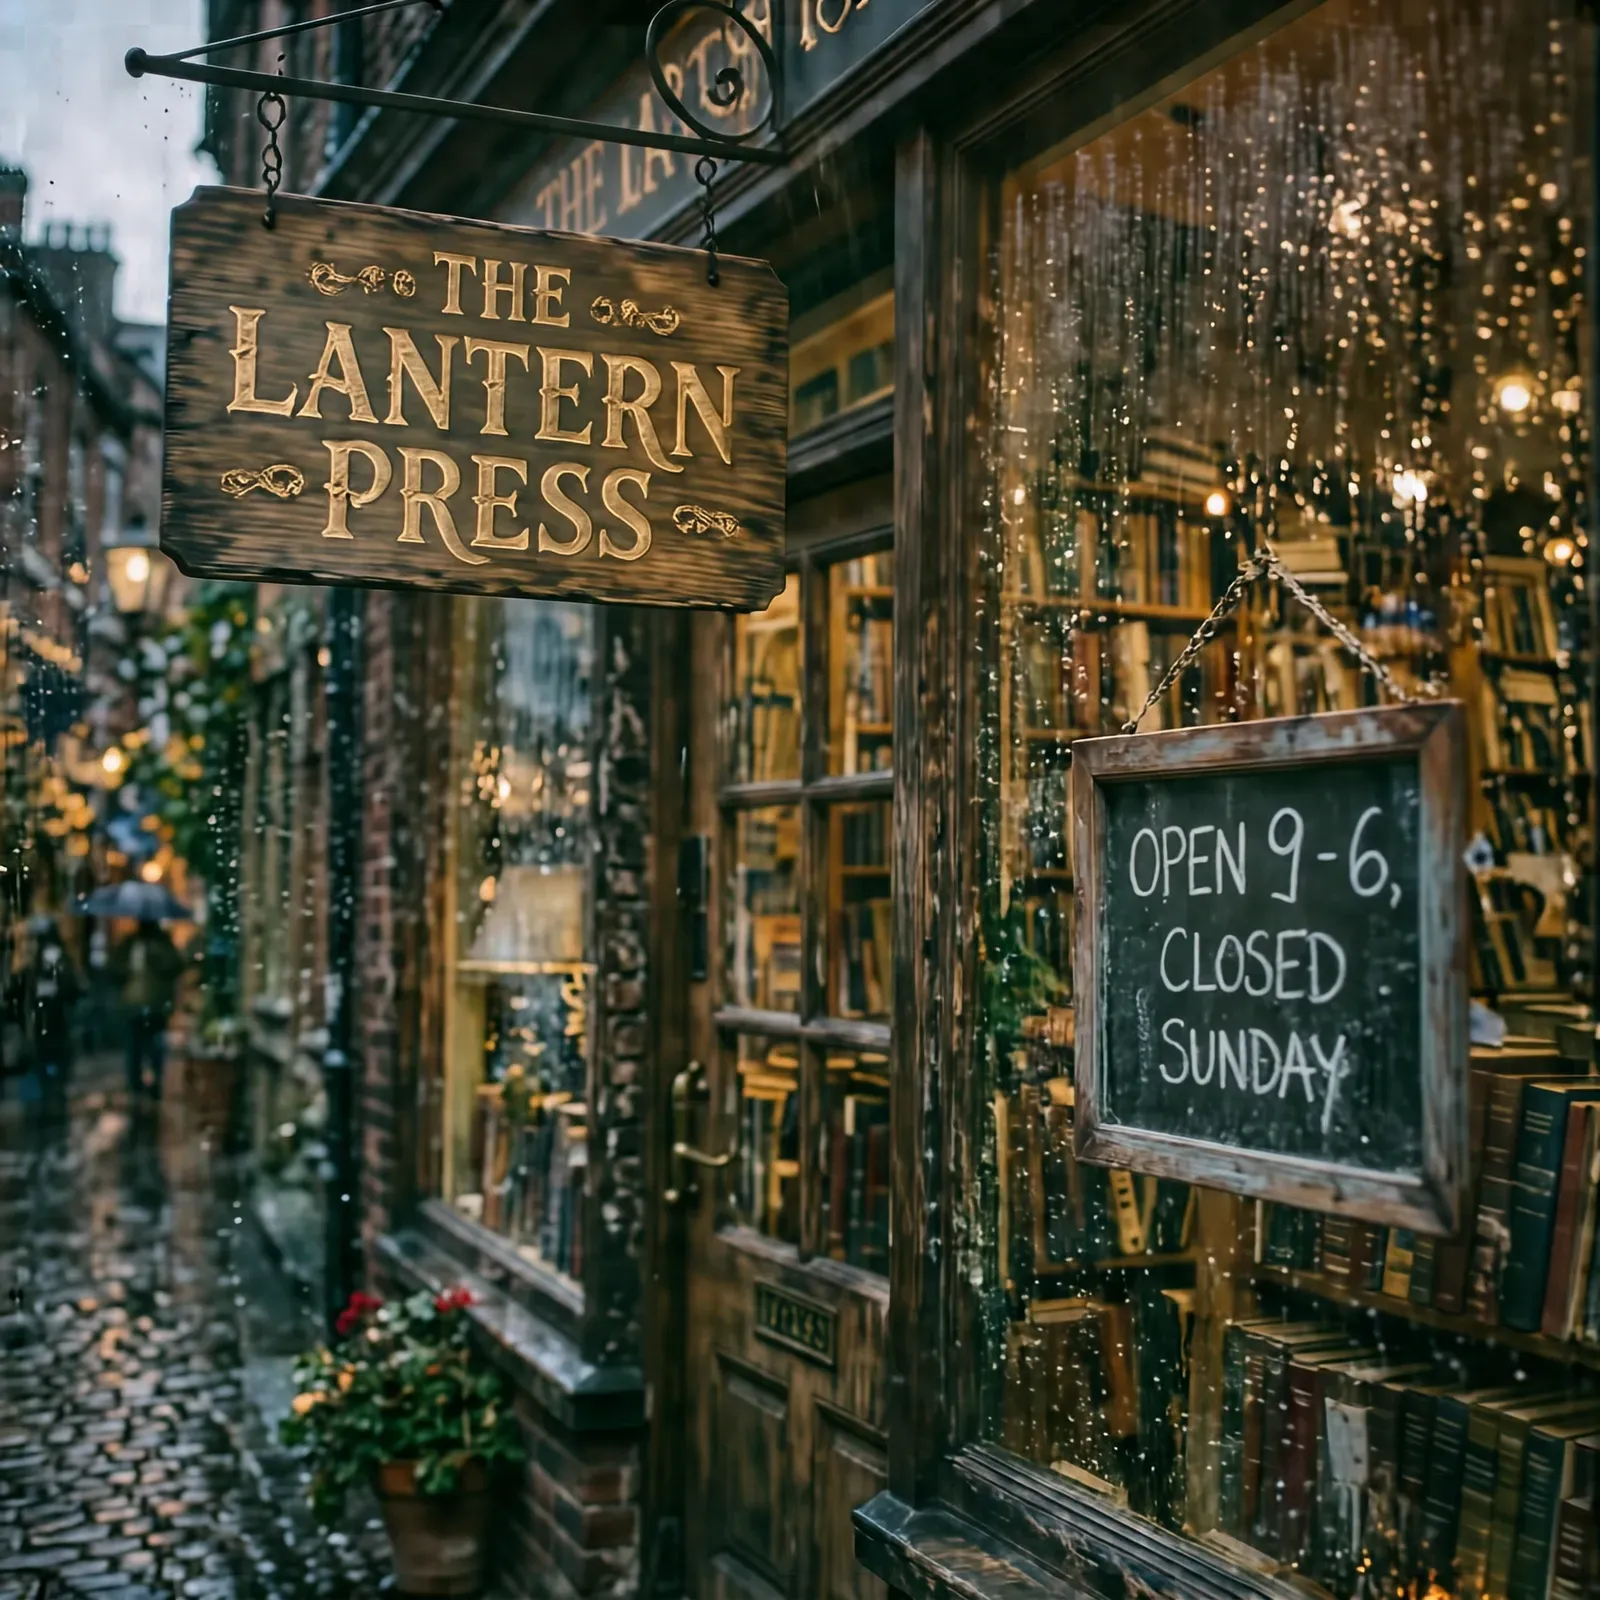
我只给了文字内容,分行、字体、材质都是模型自己决定的
有个测法上的注意:要测文字渲染,必须在 prompt 里给出要写的文字。不给的话模型会自由发挥写一堆乱码。我早先那几张基准图里,凡是画面里带标签、带书脊的地方字全是糊的,那不算文字渲染失败,因为我根本没要求它写字。
三、不能靠降分辨率提速
出图模型有个通用直觉:想快就出小图,定稿了再出大的。这个模型上不成立,而且官方在节点源码的说明里写死了:
The model was trained at ~4 megapixels; lower resolutions go off-distribution and quality regresses noticeably.
也就是说 1024×1024 不是便宜的预览档,是分布外,画质会明显退化。
官方给的训练分辨率是十一档,方的 2048×2048,横到 3104×1312,竖到 1312×3104,全都是约 400 万像素。
我拿 3104×1312 跑了一条对照:32 秒对 2048² 的 33 秒,峰值显存 13676 对 13964,几乎一样。成本只跟像素数走,跟长宽比无关。
还有一处要留神:节点的 width 和 height 下限是 64,源码不做钳位。你完全可以送一个它没训过的画布进去,它不报错,只是悄悄变差。
四、显存只吃四成
这是和上一篇最大的反差。
同一张卡,H3 跑视频时峰值恒在 97–98%,靠 DynamicVRAM 拼命换出才摁住。HiDream 出图:
| 档位 | 采样 | 平均 | 总执行 | 峰值显存 |
|---|---|---|---|---|
| Full · 40 步 · 2048² | 33 秒 | 1.18 it/s | 42.17 秒 | 13964(42.8%) |
| Full · 40 步 +Sage | 31 秒 | 1.28 it/s | 40.1 秒(墙钟) | 13324 |
| Dev · 28 步 | 8 秒 | 3.38 it/s | 16.86 秒 | 11116 |
| Dev · 28 步 +Sage | 7 秒 | 3.64 it/s | 15.0 秒(墙钟) | 11502 |
| Dev · BF16 · 28 步 | 9 秒 | 2.85 it/s | 22.40 秒 | 17080 |
| Full · 3104×1312 | 32 秒 | 1.23 it/s | 40.58 秒 | 13676 |
| Full · 50 步 | 41 秒 | 1.20 it/s | 49.07 秒 | 13932 |
+Sage 表示挂了 SageAttention。全部 2048×2048,只标出与之不同的那一项。
标了墙钟的那两格是我自己脚本量的,5 秒轮询粒度,不是 ComfyUI 报的 Prompt executed——这一批的日志后来被别的实验覆盖了,精确值取不回来。别拿这两个数去和别行算比值。其余五行都是 Prompt executed。
一半以上的卡是空的。顺带两条:50 步对 40 步严格线性(41 ÷ 33 = 1.24,50 ÷ 40 = 1.25);Dev 版是 Full 的四分之一时间,28 步对 40 步只解释一部分,另两条是它用 LCM 采样器而不是 dpmpp_2m_sde_gpu,以及不挂下面这个 seam smoothing。
那一列平均值,我第一版抄错了行
tqdm 结束时打两行,我只 grep 了含 s/it 的那一行:
 32/40 [00:19<00:04,  1.65it/s]   ← 前 32 步
 33/40 [00:20<00:08,  1.24s/it]   ← 第 33 步起,每步 ×2
 37/40 [00:26<00:07,  2.42s/it]   ← 第 37 步起,每步 ×4
 40/40 [00:33<00:00,  2.41s/it]   ← 末段瞬时速率
 40/40 [00:33<00:00,  1.18it/s]   ← 全程平均,这行才是要抄的
拿末段值当平均值,每步耗时会大出近三倍。而且它和步数乘起来会超过总执行时间,这就是自查的抓手:40 × 2.41 = 96 秒,可这一行的总执行只有 42.17 秒。
变速的拐点在第 33 步,正好是 80%。而 HiDreamO1PatchSeamSmoothing 的出厂参数就是 start_percent = 0.8、passes = "ramp_2_4"(RAMP_LEVELS 里 ramp_2_4 = [2, 4]):
| 步 | seam passes | 实测 | 核对 |
|---|---|---|---|
| 1–32(0–80%) | 不生效 | 0.61 s/it | 基准 |
| 33–36 | 2 | 1.22 s/it | 0.61×2 对得上 |
| 37–40 | 4 | 2.42 s/it | 0.61×4 对得上 |
最后 8 步只占两成,却吃掉 14 秒,占整段采样的 42%,全是 seam smoothing。
Dev 那三行怎么抄都对,因为 Dev 模板根本没挂 seam smoothing,它匀速,两行 tqdm 完全一致(3.38it/s 和 3.38it/s)。这也是它比 Full 快那么多的第三条原因。
五、量化格式:证据是数出来的
权重有三个变体:BF16、FP8 scaled、MXFP8。Blackwell(50 系)对 MXFP8 有硬件级支持,官方说比 BF16 快约三成。
MXFP8 的原理是每 32 个连续权重共享一个 8 位缩放因子,所以平均每个权重约 8.25 位。这句话我一开始是从官方讨论串里读到的,后来发现在文件里能直接数出来:
| 张量数 | dtype | 体积 | |
|---|---|---|---|
| MXFP8 | 1474 | BF16, F8_E4M3, U8 | 8.31 GiB |
| BF16 | 758 | BF16 | 15.24 GiB |
那批 U8 就是缩放因子,所以张量数正好多出约一倍;体积比 0.545,和理论上的 8.25/16 = 0.516 对得上,差的部分是有些层保留了 BF16。
实测 MXFP8 比 BF16 快 1.19×、省 6.0 GB 显存。官方说的三成、实测一成九,方向一致量级对得上。
画质我做了同 seed 对照,肉眼判看不出高下:
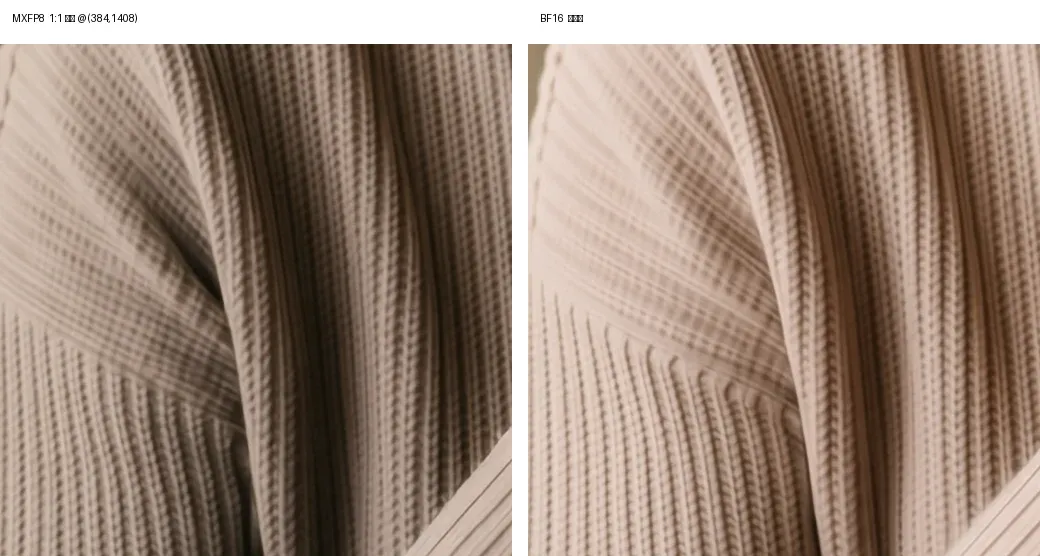
自动找出差异最大的那块 512×512 做 1:1 裁切。整幅平均绝对差 17.45/255,一半以上的像素都变了
这里有个容易误判的地方:这不是同一张图,一张糊一点。 量化改的是计算图,同 seed 出来的是两个不同的采样结果。所以判据不是哪张更清晰,而是你想发哪张。
六、SageAttention 在图片上只剩 1.08×
上一篇实测 SageAttention 在 H3 视频上是 1.89×(5 秒)到 2.35×(15 秒),并总结出一条规律:序列越长,收益越大。
这次拿图片验证这条规律,结果比我预期的还低:
| 不挂 | 挂 Sage | 提速 | |
|---|---|---|---|
| 视频 15 秒 | 88.25 s/it | 37.61 s/it | 2.35× |
| 图片 2048² | 0.85 s/it | 0.78 s/it | 1.08× |
图片这一行是全程平均(33.9 秒 ÷ 40 步、31.3 秒 ÷ 40 步),不是进度条末尾那个数,原因见上一节。视频那一行 H3 用 res_multistep 匀速、模板里也没有 seam 类节点,进度条上的值直接就是平均值。
图片的 token 序列比 15 秒视频短一个量级,所以收益几乎没有。
而且这 1.08× 没有被上一节那个 seam smoothing 稀释。逐段对照下来,seam 生效前和生效后的提速比是一样的:seam 多跑的那几遍是完整前向,照样过整个 transformer、照样有 attention,Sage 对它一视同仁。
这里差点被总耗时骗过去。Dev 那一对的总执行看着差了好几秒,但采样只有 8 秒到 7 秒,差的是模型装载,不是 Sage。看总耗时会高估加速比,得把固定开销扣掉;何况那一对总执行正是上一节标了墙钟的那两格,5 秒粒度,本来就不该拿来算比值。
七、把 ComfyUI 撑死的真正原因
这是今天最值钱的一条,也是困扰了很久的老问题。
现象在上一篇里就出现过:ComfyUI 会自己挂掉,已经发生过四到六次,每次都是控制台的内存表冲到 90% 多的时候。死状很特别,采样全部跑完,日志停在 VAE 加载那一行,之后一行没有,没有 traceback,进程直接消失。
当时的应对是启动加 --cache-none,有效,但那是知其然不知其所以然。这次查到了机制:
cgroup 真实上限          90 GiB
ComfyUI 以为的总内存    754.5 GiB   ← 宿主机的
ComfyUI 以为的可用       699.1 GiB   ← 容器实际只剩 78 GiB
comfy/model_management.py 里读内存用的是 psutil.virtual_memory(),而 psutil 读的是 /proc/meminfo,在容器里那是宿主机的数字。判断要不要腾内存的那行代码,比较对象也是宿主机的 699 GiB。
它永远算不出内存不够,于是一路缓存,直到 cgroup 把它打死。 grep -rin cgroup comfy/ 零命中,ComfyUI 完全没有 cgroup 感知。
这解释了所有细节:为什么显存 98% 没事而内存 90% 要命,前者有自适应换出、后者没有;为什么加 --cache-none 有效,把缓存整个关掉就绕开了盲区;为什么它死得那么安静,不是 Python 层的 OOM,是被外部杀掉。
八、--cache-none 是补丁,不是选项
想清楚根因之后,--cache-none 的定位就变了。它不是省内存的性能选项,是绕过盲区的补丁,而且代价不小。
去掉它、让模型常驻之后,每次换 seed 逼采样器真跑:
带 --cache-none |
不带 | 收益 | |
|---|---|---|---|
| 图片 固定开销 | 7.9–8.4 秒 | 1.6–2.0 秒 | 省约 6 秒 |
| 视频 固定开销 | 44.5–46.3 秒 | 10.8–11.4 秒 | 省约 34 秒 |
| 图片 总执行 | 39 秒 | 32.6 秒 | 1.20× |
| 视频 总执行 | 80–82 秒 | 47.8–48.4 秒 | 1.68× |
视频那条快了 1.68×,只是因为不用每次重装 40 GB 权重。这是那条 15 秒出片档的产物:
1344×768 · 362 帧 · 20 步 · 挂 SageAttention · 模型常驻。815 秒,比上一篇记录的 829 秒还快 14 秒,省下的正是重装权重的时间
但代价来了:两套模型常驻等于 60–62 GiB / 90。我拿 15 秒出片档试探边界,T2V 那条安然无恙,峰值 66.6 GiB,cgroup 的撞天花板计数器是 0;换成参考图模式,那要再装一个 19.5 GB 的模型,当场复现了上一篇记录的那次崩溃,日志停在同一行、同样没有 traceback。
峰值 86.8 GiB,采样 20/20 全跑完,没有产物,然后 SSH 和 JupyterLab 双双失联,只能在控制台重启。
但这次的数据修正了一个说法。原来以为是长片撑爆的,实测长片本身不是自变量——同样 15 秒、同样 4MP 的 T2V 好好的。真正的自变量是同时缓存了多少模型。
还有一条运维判据:内存 32 秒就从 66 冲到 83 GiB。等你看见控制台报警,手动干预已经来不及了。
九、正解:让它主动卸载
二选一其实是个假选择。ComfyUI 有官方的第三条路,我之前没注意到:
@routes.post("/free")
async def post_free(request):
    unload_models = json_data.get("unload_models", False)
    free_memory   = json_data.get("free_memory", False)
一条 HTTP 请求就能把已缓存的模型卸掉,不用重启服务、也不用牺牲常驻速度。实测:
| 步骤 | 内存 | 显存 | 固定开销 |
|---|---|---|---|
| 服务刚起 | 2.6 GiB | 508 MiB | — |
| 第 1 张(冷) | 13.2 GiB | — | 8.9 秒 |
| 第 2 张(常驻) | 13.3 GiB | — | 1.5 秒 |
/free 后 3 秒 |
5.1 GiB | 766 MiB | — |
| 第 3 张 | 13.3 GiB | — | 6.4 秒 |
三秒内生效,降 8.2 GiB。而且是真卸不是假动作,下一张的固定开销从 1.5 秒回到 6.4 秒,正是重新装载的时间。代价很清楚:一次 /free 等于下次多花约 5 秒,换来 8.2 GiB。
curl -X POST http://127.0.0.1:6006/free -H "Content-Type: application/json" -d '{"unload_models": true, "free_memory": true}'所以日常不带 --cache-none,享受模型常驻的速度;要跑大任务之前先调一次 /free。
然后我拿它去打那条崩过的 R2V。同一条配置,唯一的差别是起跑前调了一次 /free:
不调 /free |
先调 /free |
|
|---|---|---|
| 起跑时内存 | 66.5 GiB | 5.2 GiB |
| 峰值内存 | 86.8 GiB | 55.0 GiB |
| cgroup 压力计数 | high 涨到 9538 |
全部 0 |
| 采样 | 20/20 跑完 | 20/20 跑完 |
| 产物 | 没有 | 5.6 MB |
| 总耗时 | 崩了,没有 | 888 秒 |
| 服务 | 进程消失、机器失联 | HTTP 200,活着 |
峰值低了 31.8 GiB,压力计数器从九千多降到一次都没撞。二选一那道题就此不存在了。
这一轮我自己的检查脚本还谎报了一次进程崩了,因为前面为了修 PATH 把启动命令换成了 /root/miniconda3/bin/python 绝对路径,而检查脚本还在用 awk '$2=="python"' 匹配。改了启动方式,配套的检查也得跟着改,否则它会稳定地骗你。
十、切模态没有额外代价
一个原本担心的问题:用户在界面上先出张图、再出条片,中间要换模型,会不会很卡?
实测不会,而且两种配置下都不会,虽然理由不是同一个。
带 --cache-none:
| 顺序 | 固定开销 |
|---|---|
| 视频 | 44.5 秒 |
| 切回来出图 | 8.4 秒 |
| 紧接着再出一张图 | 7.9 秒 |
| 再切回视频 | 46.3 秒 |
切回来 8.4 秒对连着出 7.9 秒,差 0.5 秒,在噪声里。这一组的理由很直白:每次生成本来就要重装模型,所以切模态和连续同模态根本是同一件事。
不带 --cache-none,也就是第九节推荐的那套,也一样:切回来 2.0 秒对连着出 1.6–1.8 秒。这一组的理由不同,两套模型加起来 60–62 GiB,在 90 GiB 里同时待得下,切模态压根没触发卸载。
后一条有前提:起跑前调过 /free 就不成立了,那时候确实要重装,回到第九节那张表里 /free 之后的 6.4 秒那一档。
先出图再出片,并不比连出两条片慢。所以界面上要做的只有一件事:转圈时把状态说清楚,是正在装载模型还是第 12/40 步。剩下的都是过度设计。
完整数字
单张 RTX 5090 32GB,ComfyUI 0.30.0,HiDream-O1-Image MXFP8,官方模板值。自测数据,官方没有任何速度或显存基线可对照。
第四节开头那张表就是全部七条。补几个别处的数字:
| 权重下载 | 43.3 GB,17 MiB/s,约 45 分钟 |
| 两套模型常驻 | 60–62 GiB / 90 GiB |
| 出图峰值显存 | 11116–17080 MiB / 32607(34–52%) |
| 带卡总时长 | 约 3 小时,约 ¥9 |
装机、下载、拆模板、写提交脚本全程在无卡模式下做,¥0.1/时。这条经验来自上一篇:省钱省的是开着卡干不吃卡的活,这次执行得比上次好。
几条经验,不限于这个模型
先看许可再看画质。榜首那两个都因为许可出局了,画质对比根本没轮到。判据的顺序会决定你浪费多少时间。
官方源码里的一句话,可能推翻你整个方案。4MP 以下跑到分布外这句写在节点的 description 字段里,不在文档、不在模型卡。读源码的性价比常常高于读文档。
规律要拿新场景去验,别只在原场景里复述。SageAttention 那条序列越长收益越大,在图片上验出 1.08×,而验证成功的方式恰恰是它给出了一个我原本不会猜到的低值。
看总耗时会高估加速比,而且两头得是同一个钟。固定开销不扣掉,几乎没用的 1.08× 会被读成像模像样的加速;更隐蔽的是口径,这张主表的总执行我一开始混了 ComfyUI 报的时间和自己脚本的墙钟,混着算出来的比值全是假的。
进度条末尾那个速率是瞬时值,不是全程平均。这个模型最后 20% 的步真的慢 4 倍,抄错一行,每步耗时就大出近三倍。自查的抓手很便宜:每步耗时乘步数,不能大于总执行时间。
知其然不知其所以然的补丁,迟早要还。--cache-none 挂了很久都有效,直到想省那 34 秒才发现它的代价,而根因其实一行 grep 就能查到。
测缓存复用必须换随机种子。我第一版实验有三条 0.9 秒完成,看着像天大的优化,其实是 prompt 完全相同、ComfyUI 把上次的产物直接返回了,采样器根本没跑。
最后一条还是给自己的:这一天里,比七个速度数字更值钱的是那个 psutil 的根因。 速度换台机器就得重测,而容器里的进程看不见自己的天花板这件事,会在别的地方一再遇到。