测 12 个开源出图模型,我把自己否掉了两次
目录 · 41 节
- 先把这篇的边界划清楚
- 还有两条前提
- 我原来是怎么测的
- 四个硬伤
- 一、单 seed 不算数
- 二、不盲测
- 三、单张打分,而不是成对比较
- 四、题目太少,还没分类
- 业界实际怎么做
- 三条线
- 一条硬约束:你需要多少次判断
- 我照抄了什么,又故意偏离了什么
- 题库:三家里选一家
- 但它有三条局限,得写在结论旁边
- 实测:十二格的速度与显存
- 换个算法,排名会反转
- 四个会静默骗你的坑
- 一、显存量出来是累积值,不是模型需求
- 二、pgrep -f 脚本名 会匹配到你自己
- 三、aria2 分段下载时,文件大小不等于进度
- 四、日志全缓冲,出事看不见
- 一个意外:Ideogram 4 的安全过滤器烧在权重里
- 挂上转换器之后:12.5% 到 93.8%
- 但这里有个只看通过率会漏掉的坑
- 最后一件事:把能自动核的和只有我能判的分开
- 第一轮判完了:没有一家够到锚
- 这一轮暴露的三个方法问题
- 还有一条没解释的矛盾(记住这一条,后面它是钥匙)
- 还有一个技术事实值得记
- 原计划作废:全量 25 题没跑,GSB 决赛没做
- 又跑了四轮,一共 255 张
- 客观项查出来的东西(这些跟审美无关)
- 一、开源模型认得灭霸,不认得美杜莎
- 二、有个模型会把我写的要求当画面内容画出来
- 三、横向排列这条指令,有一半模型稳定地不听
- 四、五家能把中文招牌一字不差地写对
- 一次自我更正:塌的不是复合度,是断代形制
- 然后是这次真正的发现
- 所以这条改成了纪律
- 结论:没有一家到想发,但有一档凑活着可用
- 两次否定,其实是同一件事
我要在本地找一个出图模型,画质得顶得住云端的 Seedream。租了张 RTX PRO 6000(96 GB 显存),装了十二个开源模型,准备一家家跑。
跑之前我先花了半天查业界怎么做这种评测,结果发现自己原来那套测法有四个硬伤。
于是返工,做了一套很讲究的评测:盲测、多种子、题库分层抽样、客观项写脚本核、主观项自己判。
然后跑完五轮、255 张图之后,我发现那套讲究的判据,测的根本不是我要的东西。
这篇记的是两次自我否定:第一次否掉测法,第二次否掉返工出来的判据。中间夹着十二格的真实速度与显存,以及几个不报错、只是悄悄给你错数据的坑。
先把这篇的边界划清楚
下面所有涉及哪家好看的判断,都是我一个人的审美,题材集中在中国古代与文物历史这个很窄的范围。而且第一轮之后的四轮是单 seed,那几轮我不是在细挑,就是看一眼、凭第一眼的感觉。这些判断不构成任何普适排名,换个题材、换个人来判,结论完全可能不一样。
但这篇里还有另一类东西:匾额上那四个字对不对、模型认不认得某个角色、中文 prompt 会不会直接失效、显存到底吃多少。这些是可复现的事实,跟谁来判没关系。
两类我会分开写,也请分开读。 而这篇最后的结论,恰恰来自这两类之间的错位。
还有两条前提
一、全部是裸跑的基础模型。没有微调、没有 LoRA、没有 ControlNet、没有放大、没有 i2i 精修。而且不只是我没加,出厂就开着的优化我也主动关掉了:ERNIE 的 prompt-enhancer 默认是开的,有个 LLM 先把你的题重写一遍;HiDream Dev 的模板默认跑 i2i;Qwen-Image 附带 Lightning-4 步加速 LoRA;Krea 2 Turbo 附带风格 LoRA。四个开关我全拨到关。
所以下面所有数字都是开箱、不调教这个条件下的。挂上这些东西之后排名会不会变,这轮答不了。
唯一的例外是 Ideogram 那一档:它前面挂了个 LLM caption 转换器,那就是一种优化手段,所以它单列成非裸跑,不跟裸跑组混排。后面会专门讲。
二、权重精度没拉平,这是个我没控制住的变量。十二格里大多数跑的是 fp8 量化版(FLUX.1 / FLUX.2 / Ideogram / Krea 2 / Qwen-Image),HiDream 是 mxfp8,而 Z-Image 那两格跑的是未量化的 bf16。
量化会不会吃掉画质、吃多少,这轮没测。所以但凡涉及 Z-Image 与别家的画质比较,都得记着它占了个精度上的便宜。
我原来是怎么测的
第一版很朴素:六道题,每个模型每题跑一张,出图发出去看,觉得哪个好就是哪个好。
跑完三个模型之后,我拿着一堆图去查别人怎么做对比测试,然后就没法接着跑了。
四个硬伤
一、单 seed 不算数
同一个 prompt,换个随机种子,构图会整个变。
ICLR'25 有篇 Spotlight 叫 All Seeds Are Not Equal,说的就是这件事:不同的初始噪声会系统性地改变物体摆放和构图,某些种子稳定地比别的好。
这意味着单 seed 的对比里,你分不清看到的差别是模型差别还是运气差别。
这条还顺手动摇了我之前的一个结论。我早先测 FLUX.1 时记过一句,prompt 换了五版,构图全塌成对称走廊。现在看,构图塌陷本身就可能是种子效应,那个结论得打折。
二、不盲测
我之前是带着文件名把图发出去的:X_flux2_Q1_skin.png。
看的人知道这张是谁出的。业界三条线,LMArena、Artificial Analysis、厂商自评,全都专门防这个:隐藏模型名、随机左右位置、投票之后才揭示身份,有的还加最短观看时间门槛。
三、单张打分,而不是成对比较
这张好不好,比 A 和 B 哪个好噪声大得多。没有哪个正经榜单是靠单张打分排名的。
四、题目太少,还没分类
六道题排十二个模型,两两组合有 66 对。这个量级连统计上的门槛都够不着,下一节会算给你看。
业界实际怎么做
三条线
自动 benchmark 那条线正在失效。GenEval、DPG-Bench 这些跑分工具,问题不在设计,在于判分器跟不上模型进步。GenEval 2 实测原版 GenEval 与人类判断的绝对误差已经到 17.7%。
所以这条线我整条不用,它们已经漂了,而且跟想不想发没关系。
顺带一提,Stanford 的 HEIM 框架有个思路我直接拿来了:不要用单一分数排名,把评测拆成互相独立的维度分别看。它拆了 12 个维度评 26 个模型,核心结论是没有任何单一模型在所有维度领先。
Arena 那条线是事实标准。Artificial Analysis 的方法论页写得最细,我照抄了这几条:prompt 按使用场景与能力两轴打标、均匀采样;每月淘汰胜率与掷硬币无异的题;参数用各家自己发布的默认值;各家跑自己支持的最高分辨率,再统一降采样到 1024² 比较;Bradley-Terry 最大似然算分,折算成 ELO 区间。
厂商自评那条线给了我判定协议。Z-Image 的技术报告里,它跟 FLUX.2 dev 单挑用的是 222 条 prompt × 每条 3 名独立标注员 × GSB。
GSB 就是 Good / Same / Bad,允许平局,胜率算 (G + 0.5S) / (G + S + B)。
允许平局这一点是关键。强制二选一会制造虚假的区分度,两张都不行的时候逼人选一个,选出来的那个就成了更好。
一条硬约束:你需要多少次判断
How Many Human Judgments Are Enough 给了个公式,n ≈ 2.63 / δ²,δ 是两个模型真实的偏好差。
| 两模型真实差距 δ | 需要的判断数 |
|---|---|
| 0.20(一眼分得出) | 66 |
| 0.10 | 约 263 |
| 0.05 | 约 1051 |
而且 Chatbot Arena 有 17.6% 的模型对,即便攒够 200 次判断,仍然处在低信号区,就是说还是分不出来。
这张表推出来两条纪律。先做 pilot,先小规模跑一轮估出效应量,再决定要不要投大,别一上来就 1200 张。以及判不出高下不等于两个模型一样好,大多数时候只是样本不够,结论里得把确认打平和样本不足分开写,不然就是在拿沉默冒充结论。
我照抄了什么,又故意偏离了什么
| 项 | 业界做法 | 我的做法 | 为什么 |
|---|---|---|---|
| 盲测 | 隐名、位置随机 | 照抄 | — |
| 参数 | 各家官方默认 | 照抄 | — |
| 分辨率 | 各家最高,再降采样到 1024² 比 | 照抄 | 顺带解决了一个麻烦,见下 |
| 比例 | 统一 1:1 | 照抄 | 消掉宽高比这个混淆变量 |
| seed | 1 张 / seed 42 | 偏离:4 个 seed | AA 靠海量 prompt 平均掉方差,我 prompt 少,只能靠多种子 |
| 蒸馏版 | 归为 Modified、默认从榜上隐藏 | 偏离:照测,但分组 | 我本来就要跑得快的;但 8 步的和 50 步的不混一张榜 |
| prompt-enhancer | 用各家默认 | 偏离:一律关掉 | 见下面那段 |
分辨率那条为什么重要:HiDream 只训了约 4 MP 的十一个档位,强行降到 1024² 会跑到分布外、画质明显退化。而各家跑自己的、比较时统一降采样这个做法,天然就照顾到了这一点,不用为它开特例。
enhancer 那条是我坚持要偏离的。我拆开各家的出厂工作流之后发现,ERNIE 和 HiDream 的官方模板默认是开着 prompt-enhancer 的,有个 LLM 子图先把你的 prompt 重写一遍再喂给模型。挂着它跑,等于让这两家用改写过的题应试,所以我一律关掉。这是有意偏离官方默认,得在文档里写明。
题库:三家里选一家
自己编题是最差的选项,编的人有倾向,而且没法让人复现。所以去找公开题库,最后比了三家:
| OneIG-Bench | Qwen-Image-Bench | DynEval | |
|---|---|---|---|
| 日期 | 2025-06(榜 2025-09 停更) | 2026-05 | 2026-07 |
| 题量 | 1120 英 / 1320 中 | 1000(中英各半) | 1000 |
| 中文质量 | 机翻 | 原生双语专家撰写 | 未说明含中文 |
| 有没有 AI 感这一项 | 没有 | 有 | 没有 |
| 附带参考图 | 没有 | 18 个模型 × 各 1000 张 | 没有 |
选 Qwen-Image-Bench,三条硬理由。
一是中文是原生撰写不是机翻。OneIG 的中译我实测过,swept bangs 翻成扫帚刘海、middle of w 翻成 w的中间。拿机翻的题测中文能力,测出来的是模型对烂中文的容忍度。
二是每道题标注了它考哪几个细粒度维度,一共 56 个三级标签,可以按维度分层抽样,不用凭感觉挑。
三是它专门有一项叫 Quality / Detail / Naturalness,中文标的是图像质量-细节度-AI 感。全库 1000 条里只有 57 条带这个标签,而一眼假恰恰是我判死上两个模型时用的词。
还有个意外之喜:它把 18 个模型各 1000 张的出图也一起发布了,其中就有 Seedream。我的参照物白送。
但它有三条局限,得写在结论旁边
时间差。题库 2026-05 定版,我测的十二个模型里有十个是它停更之后才出的,榜上一个都没有。所以能跟论文数字对照这条好处,实际上不成立。
利益冲突。题库是阿里出的,而我要测的模型里就有阿里的 Qwen-Image。缓解办法是用人评、不使用它自带的判官模型,但这条得标出来。
参照图不是最新档。我实际在用的是 Seedream 5.0 Pro,而 Pro 的 API 是 2026-07 才上线的,题库 2026-05 定版,榜里那个 Seedream-5.0 不是 Pro。
这条我实测量过差距:同一道人像题,Pro 和非 Pro 并排看,非 Pro 明显磨皮、毛孔几乎不可见,而那道题的要求里明写着无 AI 蜡像感。两张分辨率不同(2048² 对 1024²),所以我又把 Pro 降采样到 1024² 重比了一次,差距依然明显。这就排除了唯一的混淆变量,可以确定那是模型代差,不是分辨率。
这一处没有配图:非 Pro 那半边是题库附带的参照图,题库本体是 Apache 2.0,但那 18000 张参照图是各家商业模型的产出、许可没有单独声明,所以我只在本地做对照,不往外发。
所以那 18000 张白送的参照图只能当下限线:连非 Pro 都打不过的,不用谈 Pro。
实测:十二格的速度与显存
各格用自己的出厂分辨率与出厂参数,跑 8 题 × 4 seed = 32 张,取热跑中位数,首张含模型加载、单独列。
| 键 | 步数 / 分辨率 | 首张 | 热跑中位 |
|---|---|---|---|
| Z-Image-Turbo | 8 步 · 1024² | 19.8 s | 1.9 s |
| Krea 2 Turbo | 8 步 · 1024² | 24.0 s | 3.0 s |
| FLUX.1 dev | 20 步 · 1024² | 22.1 s | 5.9 s |
| HiDream-O1 Dev | 28 步 · 2048² | 24.5 s | 7.3 s |
| Ideogram 4 | 20 步 · 1024² | 22.2 s | 7.4 s |
| Kroma v0.2-turbo | 10 步 · 1024² | 32.2 s | 8.1 s |
| Z-Image base | 25 步 · 1024² | 21.8 s | 9.5 s |
| ERNIE Image | 20 步 · 1024² | 30.4 s | 9.7 s |
| FLUX.2 dev | 20 步 · 1024² | 61.4 s | 11.8 s |
| HiDream-O1 Full | 40 步 · 2048² | 45.2 s | 26.2 s |
| Qwen-Image 2512 | 50 步 · 1328² | 67.1 s | 50.1 s |
最快到最慢差 26 倍。
换个算法,排名会反转
上面那张表对 HiDream 不公平,它跑的是 4 MP,别家跑 1 MP。换成每百万像素秒数:
| 模型 | 分辨率 | s / MP |
|---|---|---|
| HiDream-O1 Dev | 2048² | 1.74 |
| Z-Image-Turbo | 1024² | 1.81 |
| Krea 2 Turbo | 1024² | 2.86 |
| FLUX.1 dev | 1024² | 5.62 |
| HiDream-O1 Full | 2048² | 6.25 |
| FLUX.2 dev | 1024² | 11.24 |
| Qwen-Image 2512 | 1328² | 28.5 |
HiDream-O1 Dev 的吞吐是全场第一:它 7.3 秒出的是 4 MP 图,Z-Image Turbo 1.9 秒出的只有 1 MP。
四个会静默骗你的坑
这四个的共同点是都不报错。你以为在正常跑,实际上拿到的是错数据。
一、显存量出来是累积值,不是模型需求
我第一遍量的显存长这样:
HiDream Full  13.6 GB
HiDream Dev   19.7 GB
FLUX.2        70.7 GB
FLUX.1        88.1 GB
Krea 2 Turbo  96.9 GB   ← 然后第六个模型加载时,服务崩了
看出问题了吗?它单调递增。
ComfyUI 会把跑过的模型都缓存在显存里不放。跑到第五个时已经占了 96,957 / 97,887 MiB,第六个模型 12.5 GB 一加载,直接把服务搞崩,跑图脚本跟着报 Connection refused 退出。
不是主机内存不够(还剩 948 GB),也不是权重损坏(字节数校验一致)。修法是每换一个模型前主动 POST /free。
修完再量,结论跟第一版完全相反:
| 模型 | 第一遍(累积值) | 腾干净后的真值 |
|---|---|---|
| HiDream-O1 Dev | 19.7 GB | 11.05 GB |
| HiDream-O1 Full | 13.6 GB | 13.51 GB |
| FLUX.1 dev | 88.1 GB | 17.85 GB |
| Krea 2 Turbo | 96.9 GB | 18.81 GB |
| FLUX.2 dev | 70.7 GB | 53.22 GB |
HiDream 跑 2048² 只要 11 GB,是全场最省的;FLUX.2 跑 1024² 要 53 GB,差四倍。 而第一张表给人的印象正好反过来,因为 HiDream 排在第一个跑,锅是空的。
FLUX.2 那 53 GB 也说得通:主干 fp8 混合精度 33 GB 加文本编码器 16.8 GB,光加载就 50 GB 起步。
这里还有个二阶坑。我重测 FLUX.1 时拿到 34.7 GB,但那一格 /free 之后的基线是 36 GB 而不是 828 MB,上一个模型没释放完。峰值比基线还低,数字自相矛盾,单独重测才拿到干净的 17.85 GB。所以 /free 之后要回读基线,没回到空盘状态,那次测量就作废。
二、pgrep -f 脚本名 会匹配到你自己
我写了个哨兵等跑图结束:
while pgrep -f runner12.py >/dev/null; do sleep 60; done它永远不会退出。因为这条命令自己的命令行里就含 runner12.py 这个字符串,pgrep -f 匹配的是完整命令行,于是它一直匹配到自己。
后果是 ComfyUI 崩了二十多分钟,哨兵还在安静地循环报告仍在跑。这个假阳性比前一个更危险,它让你以为一切正常。判进程死活要么排除自身,要么干脆锚在服务答不答话上。
三、aria2 分段下载时,文件大小不等于进度
用 aria2c -x16 --file-allocation=none 下大文件时,stat 看到的是当前最大写入偏移,不是已下载量。实测文件看着 12.0 / 12.3 GB 快满了,aria2 日志才 68%。
判完成只能看 .aria2 控制文件消失,别用文件大小。我的自动化脚本因为这个差点在权重没下完时就开跑。
四、日志全缓冲,出事看不见
Python 的输出重定向到文件时是全缓冲。跑了半小时,pilot.log 还是 0 字节。上面那次崩溃就是这么被拖了二十多分钟才发现的,我只能靠数输出目录的文件数来猜进度。
python -u,一个参数的事。
一个意外:Ideogram 4 的安全过滤器烧在权重里
跑到 Ideogram 4 那格,出来的图全是一张灰底占位图,上面写着 Image blocked by safety filter。
32 张里有 28 张是这个。像素标准差恒在 11 左右,正常照片是 46–55,这个差距大到可以直接拿来当自动判据。
第一反应是我配错了。查下来不是:ComfyUI 源码里 grep 不到这句话,它的节点源码里没有任何 safety 相关代码,连埃菲尔铁塔晨光、故宫冬日雪景这种题都被拦。
ComfyUI 官方的发布文确认了:这个过滤器烧在模型权重里,ComfyUI 侧无法调整、关闭或覆盖。社区甚至专门做了个工具,在采样中途检测到输出坍缩成平坦灰图就提前中断,省算力。
真实的通过率是 4 / 32 = 12.5%。而且有个更有意思的现象:同一道题不同种子,结果不一样,故宫雪景 4 张过了 3 张,人像 4 张只过了 1 张。说明这个判断带随机性,不是纯由内容决定。
这里我犯了个错,值得记下来。我一开始只抽查了一张就下结论说 32 张全废,后来逐张算像素标准差才发现有 4 张是好的,而且那 4 张的质量是全场第一档,标准差 46–55,正常照片的水平,被拦的那些是 11。差点因为抽查一张就把一个好模型判死。
它的官方工作流其实是先用一个 LLM 把自然语言转成结构化 JSON caption 再喂给模型,纯文本的误报率会高很多。但那就不是裸跑了,所以这一格得单开一档,不跟裸跑组混排。
挂上转换器之后:12.5% 到 93.8%
后来照官方开源仓(不是 ComfyUI 的转述)复刻了那套 caption 工序,通过率从 4/32 涨到 30/32。裸跑时全拦的六道题全部救回 4/4,唯一没救回的是直射光下的人脸特写,单人正面近景本来就是这类分类器误报率最高的一档。
过程里纠正了我三条误读,第三条最要命。官方 schema 里根本没有 aspect_ratio 这个键;官方代码在喂给模型之前会把 aspect_ratio 和 bbox 一起删掉,那个键只是给 LLM 内部定位用的锚;而我之前那次手工包成最小 JSON 也被拦的实验,三条全踩了——带着非法键、background 是空串、elements 是空表。
所以那次的结论 JSON 也救不了是错的。不是 JSON 救不了,是那份 JSON 本来就不合规。
跑了两个对照组才定位到真正起作用的东西:加上 style_description 是 93.8%,把 aspect_ratio 加回去还是 93.8%,两个都不是变量。真正起作用的是 compositional_deconstruction 里有没有真内容,背景要有一段实打实的场景描述,元素要一件件列全。最小 JSON 把这两处留空,等于把信息量退回自然语言那一档,当然照样被拦。
但这里有个只看通过率会漏掉的坑
第一版转换器出来的 caption,把商代宗庙祭祀写成了 A digital 3D rendering of ...。
内容一件没丢,巫祝、三件青铜礼器、灯树、禁止项全在,通过率也是 4/4。
但这一格判的是照片级真实。介质被换成 3D 渲染,等于换了考题,那四张图全部作废。加了一条题目没点名介质时不许出现 3D 渲染、数字绘画、插画的校验之后重转、重跑全部 96 张,上面那些数字都出自加校验之后那一轮。
教训写成一句:通过率上去了,和题还是那道题,是两件事,必须分开验。
最后一件事:把能自动核的和只有我能判的分开
224 张图,全量会到 1200 张,我不可能一张张看过去。但想不想发这个判据,又只有我自己能给。
所以把判据拆成两类:
| 类型 | 谁判 | 例子 |
|---|---|---|
| 客观项 | 写脚本逐条核 | 断代穿帮、器形对不对、文字准不准、手指数量、计数与空间关系 |
| 主观项 | 只有我能判 | 想不想发 |
客观项我交给脚本核。某个模型的四个种子全都把商代场景画成了明清风格(紫色丝绸袍、木桌、宫灯),那就直接标断代崩、出局,这八张图我根本不用打开。
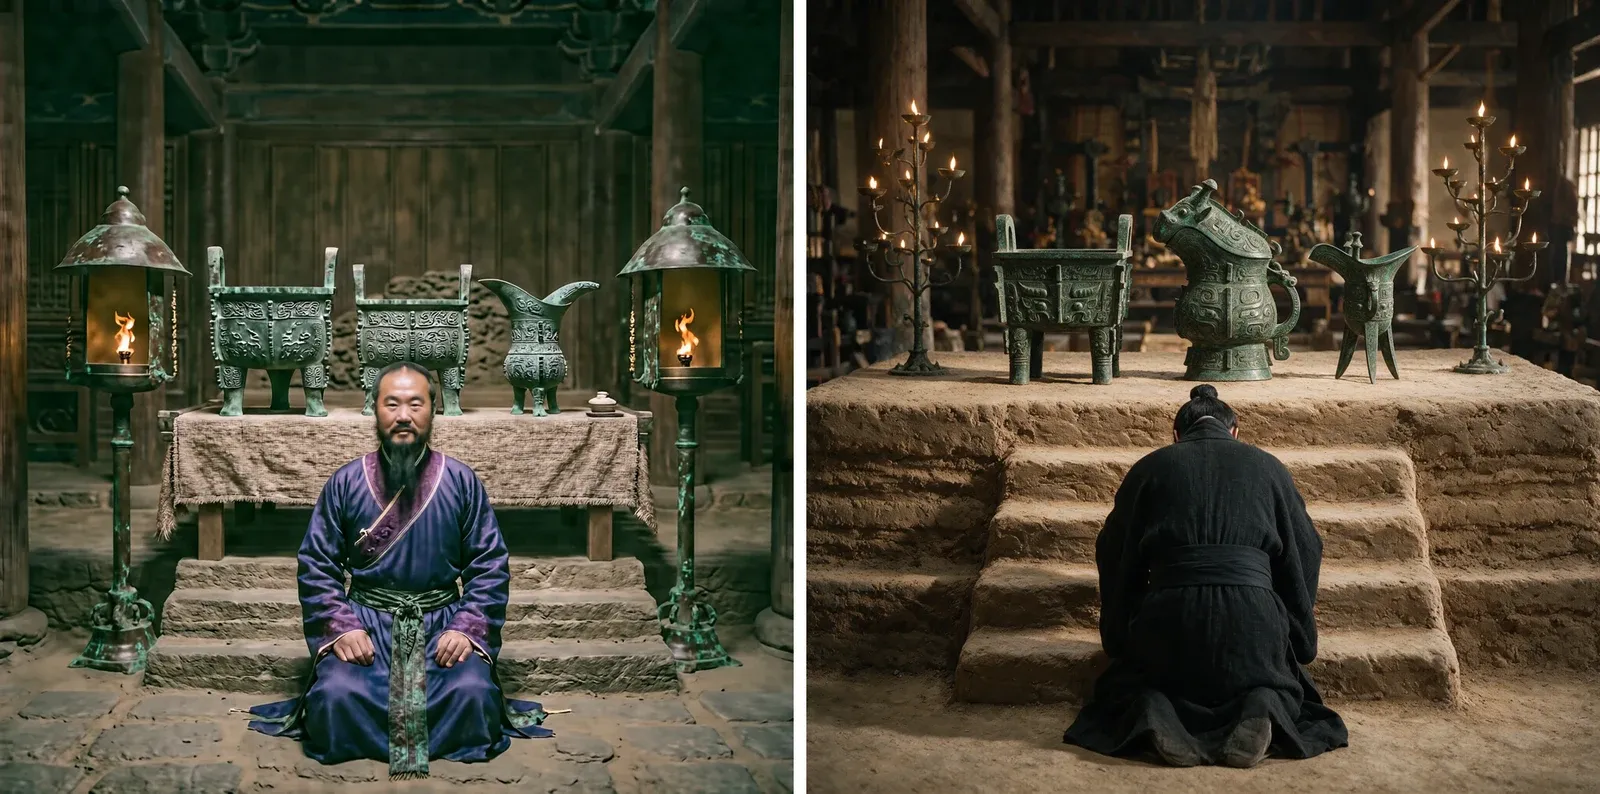
同一道题。左边这家四个种子稳定地画成明清道观:紫色丝绸袍、木桌、带罩宫灯。右边是云端那家:黑麻袍、夯土台阶、青铜枝状灯树,连方鼎、觥、爵三件器形都对。左边这八张我不用打开就能判出局。
这一轮下来,我要亲眼看的图直接少了七分之二。
剩下的判图也有讲究,这几条是想清楚之后定的。按模型切,不按题切:一屏一个模型的八道题,回答的是这家留不留,十二屏两分钟扫完,按题切留到决赛。缩略图按题型定制裁切,人像给脸部原尺寸、器物给器身、场景给全图,因为拼图里每格 300px,毛孔和铜锈全糊了,而那正是判据。第一轮只看一个种子,四个种子留到决赛判稳定性。用排除法不用挑选法,问哪些一眼出局,不问哪个最好,人对前者的判断快好几倍,不打分,只做留与不留的二分。每屏混一格云端参照当锚,但我自己不知道是哪一格。
第一轮判完了:没有一家够到锚
挑片台做出来之后,第一轮盲测判完了:12 家本地模型加 3 家云端参照,853 张图,三遍走完约 40 分钟。
判的方式是一屏一家,九格,它自己的八道题外加一格云端参照当锚,不标名字混在里面。所以会有一道题出现两格,我自己也不知道哪格是它。
结果留下 4 家。但按每题机会归一之后,那个锚只在 5 道题上有图,直接比总数不公平:
| 张 / 题 | |
|---|---|
| Seedream 5.0 Pro(锚) | 1.00,五题全被圈中 |
| 最好的开源 | 0.62 |
没有一家够到锚。我当场的判断是:中国古代那个场景,我看得上的只有 Seedream 5.0 Pro。
这一轮暴露的三个方法问题
一、判据会随疲劳漂移,一轮里漂了三次:粗筛时松、逐张圈时中、回看时严。下一轮要把粗筛和终评拆成两轮,一轮里只用一个标准。
二、消融档会偷偷制造曝光加成。Ideogram 有三个变体档,我在按模型看那屏挡住了它们,否则同一家占三屏,等于三倍抽卡机会;但按题看那屏没挡住,逐张圈图时它仍然有三倍出场机会,三档合计被圈了 31% 的图,而它主档单独算只有 0.62 张/题,跟别家一个水平。那 31% 是采样量优势,不是模型优势。这条还没修。
三、题库对具体项目不是等权的。有四道题(故宫雪景、埃菲尔铁塔、两道人像)九家都能出想发的图,根本区分不出东西;真正的分水岭全在先秦场景和青铜器那几道。所以看结论时不能让那一堆好看的人像图把判断带跑,题目的区分度得单独审,不是凑够数量就行。
还有一条没解释的矛盾(记住这一条,后面它是钥匙)
有一家模型,盲测逐张圈图时被选中 5 次、覆盖 5 道题,是全场覆盖最广的,而且它是唯一没有曝光加成的那家;但在粗筛整屏看的时候,被判了不留。
不看名字时选了它五次,看整屏时把它划掉了。
当时我把它记成一条待复核的矛盾,以为是我哪一遍看走了眼。后面四轮跑完才知道,它根本不是矛盾。
还有一个技术事实值得记
Ideogram 的 API 同一个 seed 不复现。
我拿两个内容完全相同的 prompt 跑,其中一个多带了个会被官方代码删掉的无效键,所以模型看到的输入是一样的,出来的图完全不同——平均像素差 11.6~26.6,差异像素占 77%~99%。那不是元数据差异,是两张不同的图。
而本地 ComfyUI 同 seed 重跑是逐字节相同的,实测验过。
这个差别有实际后果:云端模型的消融实验,你分不清差异是变量起作用还是纯抽卡。真要判某个参数有没有用,得同档跑两次先拿一条基线出来,那要花钱。本地模型没这个问题。
原计划作废:全量 25 题没跑,GSB 决赛没做
按原计划,下一步是把留下的 4 家拉去跑全量 25 道题,再做 GSB 对决。两件都没做,而且是有理由地没做。
全量不跑,因为第一轮已经暴露了有四道题九家都能做好、区分度为零。25 道题里这类占大半,扩题量只会把都不行测得更贵,不会测得更清楚。
GSB 不触发,因为它的前置条件是某个本地模型打平或胜出。第一轮的结果是没有一家够到锚,条件没满足,这一步按设计就不该做。
改成了另一件事:换维度,一轮一轮地问那到底是哪儿不行。
又跑了四轮,一共 255 张
每轮五道题左右,换一个能力维度,每格一张,seed 42。
| 轮 | 维度 | 题目举例 |
|---|---|---|
| 二 | 中国古代 | 汉代市肆匾额上的四个字、商代夜祭的单光源灯树、手托青铜爵的近景 |
| 三 | AI 漫剧 | 三格漫画的角色一致性、九宫格每格中文、对白气泡的尾巴指向、景别递进 |
| 四 | 单层诊断 | 只留材质、只留光影、只留人物质感,其余全剥掉 |
| 五 | 科幻 / 魔幻 / 复杂场景 / IP | 赛博城市、漂浮空岛、二十人的稷下学宫辩论、灭霸、美杜莎 |
为什么后面全是单 seed?因为这四轮的定位跟第一轮不一样。第一轮是三遍细挑、40 分钟走完 853 张;后面这四轮我不细挑,就是看一眼、凭第一眼的感觉。第一眼看不上的东西,多给三个种子也不会变成想发的。
这跟前面单 seed 不算数那条不冲突,但打的折得说清楚:单 seed 定不了精确名次,它只够回答这一档能不能看。
客观项查出来的东西(这些跟审美无关)
这一类是可复现的,我先单独列。
一、开源模型认得灭霸,不认得美杜莎
第五轮我出了两道 IP 题,只给角色名,不描述长相,要测的是模型脑子里有没有这个角色,把体貌特征写全了就变成测渲染了。
| 题 | 结果 |
|---|---|
| 漫威的灭霸 | 9 / 9 全部认得出。紫皮肤、方下巴的纵向沟纹、金蓝配色盔甲、无限手套,特征稳定复现 |
| 《斗破苍穹》的美杜莎女王 | 0 / 9。没有一家画出原作那个角色 |
失败的方式还分成两拨:一拨直接退回希腊神话那个蛇发女妖,蛇发、希腊石柱、蛇尾;另一拨画的是泛东方的带蛇女王,中式宫殿、眼镜蛇、繁复头饰,看着有那么点意思,但同样不是原作里的人。
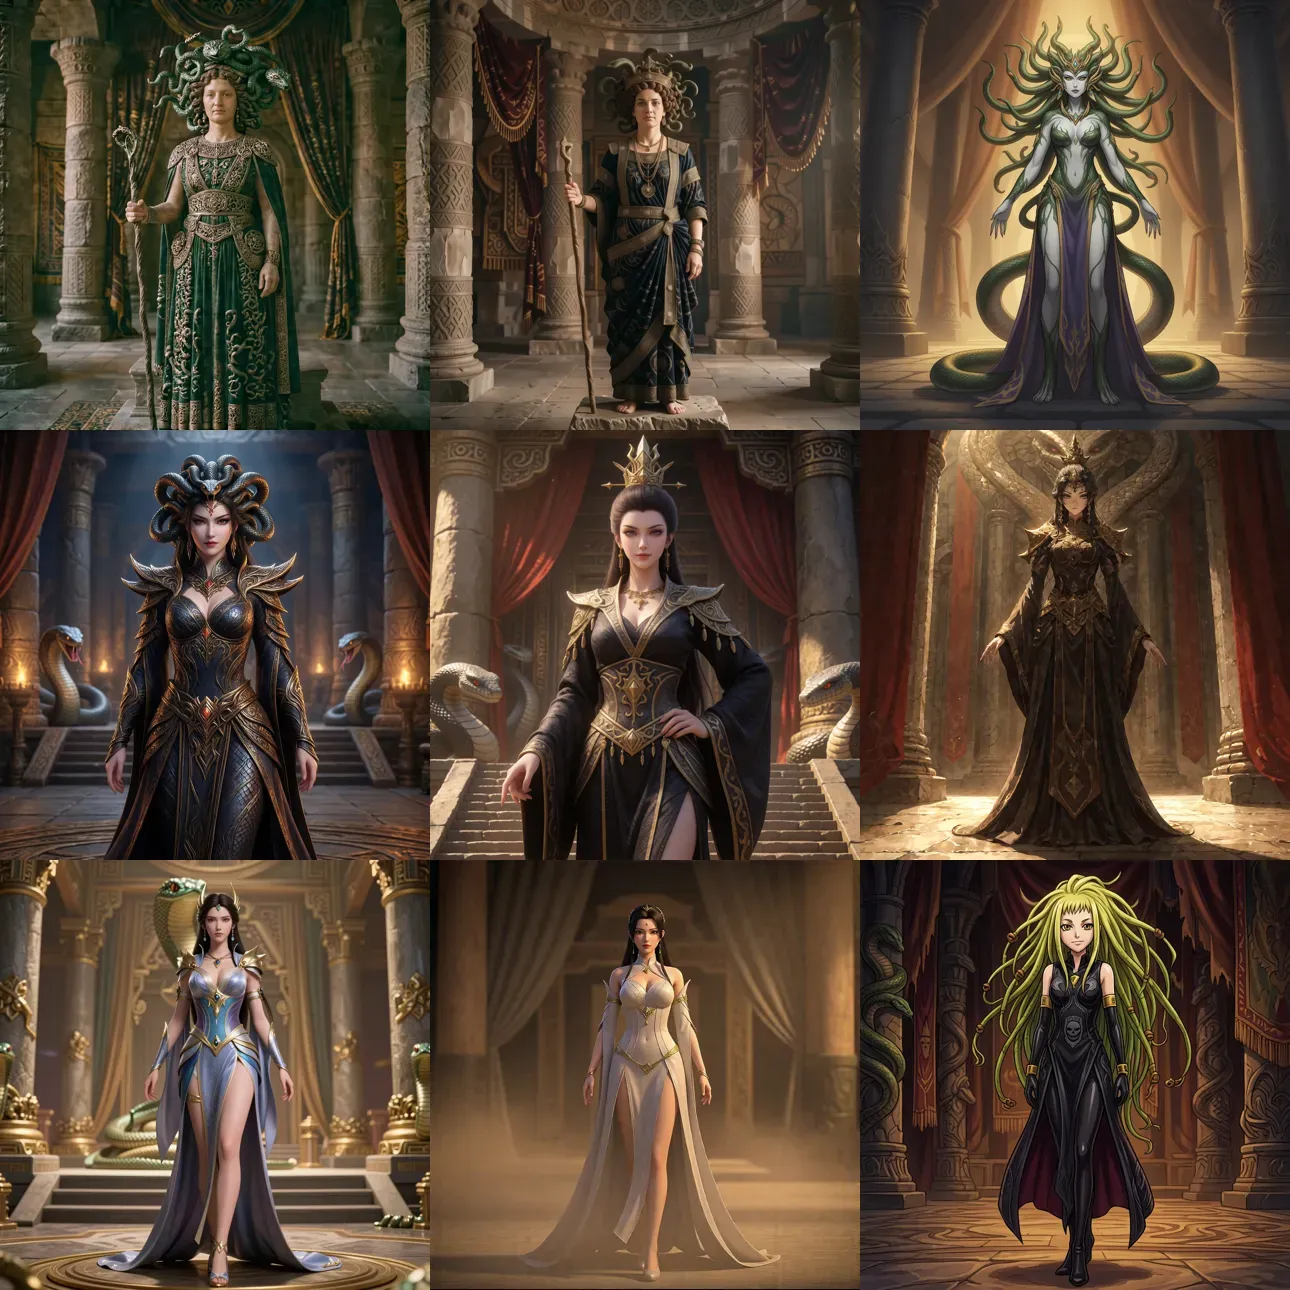
同一道题,九家。左上三张退回了希腊神话,中间和下排几张换成了泛东方的蛇族女王。没有一张是原作里的那个角色,而这道题我只给了角色名和出处,没描述长相。
共同点是美杜莎这个名字盖过了斗破苍穹这个限定。中文网文和国漫的角色,不在这些模型的世界知识里。
对做内容的人来说这是条硬约束:国漫和网文 IP 靠 prompt 点名行不通,必须走参考图。
还有个次级发现:认得出角色不等于记得住道具。无限手套应该是六颗宝石一字排开,九家里没有一家数量和排布完全正确,多数是四五颗散布在拳背上。
二、有个模型会把我写的要求当画面内容画出来
我的 prompt 末尾习惯写一段约束,比如要求气泡尾巴不得指错人、不得悬空。
有一家模型把这段话当成台词画进了气泡里,画面上明明白白写着不得指错人、不得悬空。
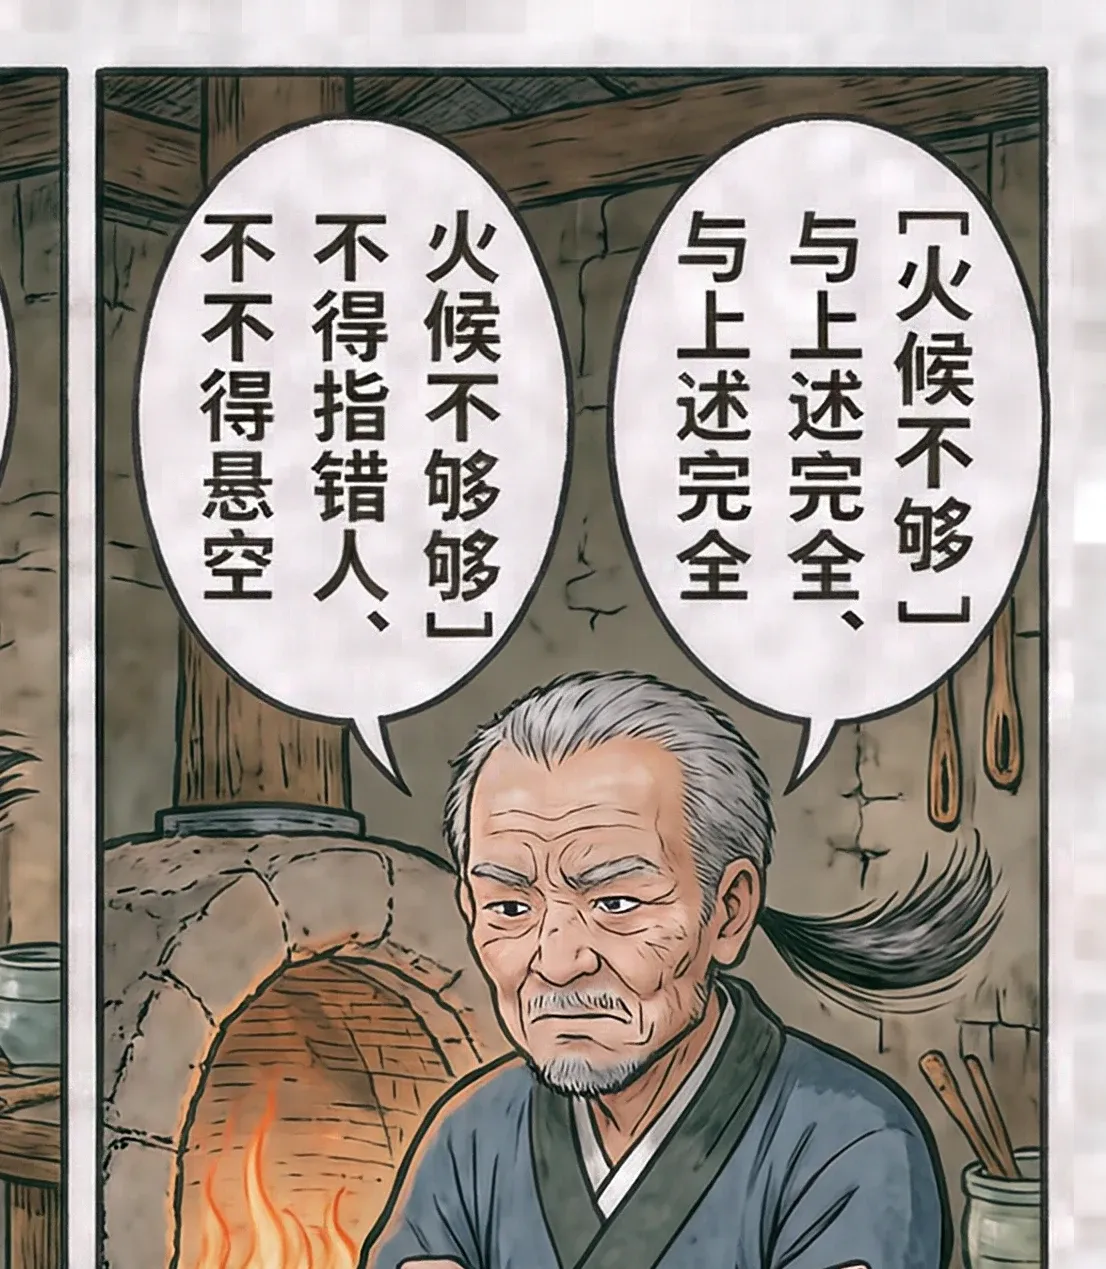
气泡里该出现的只有火候不够四个字。不得指错人、不不得悬空、与上述完全,全是我 prompt 末尾那段约束,被它当成台词画了上去。
同一族毛病四轮都在复现。另一道题里,它在画面上写出了四格画、不得出须能认出是同子,那是我四格必须能认出是同一个人那句被渲染成了画面文字,而那道题的要求正是四格不得出现文字。还有一次,它在殿门匾额上写了下瞅楼殿、大鹏宫这类根本不存在的词,题目压根没要求任何文字。
它不区分描述和约束。对策很具体:给这家写 prompt 别写要求那一段,把约束改写成正面描述,不写不得有桌椅,写席地而坐的空旷夯土地面。
三、横向排列这条指令,有一半模型稳定地不听
有两道题我写了三格分镜、横向排列。
结果模型分成了泾渭分明的两派,一派老老实实横排,另一派一律排成竖排。两轮不同的题,落在同一边的还是同一批模型。
这就不是抽卡波动,是稳定性格。做横版分镜的话,模型选择会被这条直接卡住,跟画质好坏没关系。
四、五家能把中文招牌一字不差地写对
有道题要求匾额上横书东市酒肆、幡旗上竖书酒与浆。这个判据没有解释空间,字对就是对,错就是错。
五家两处全对。错的那几家错得很有意思:东酒酒肆、膳市酒东、东市酒糶,还有把幡旗写成酒漾的。
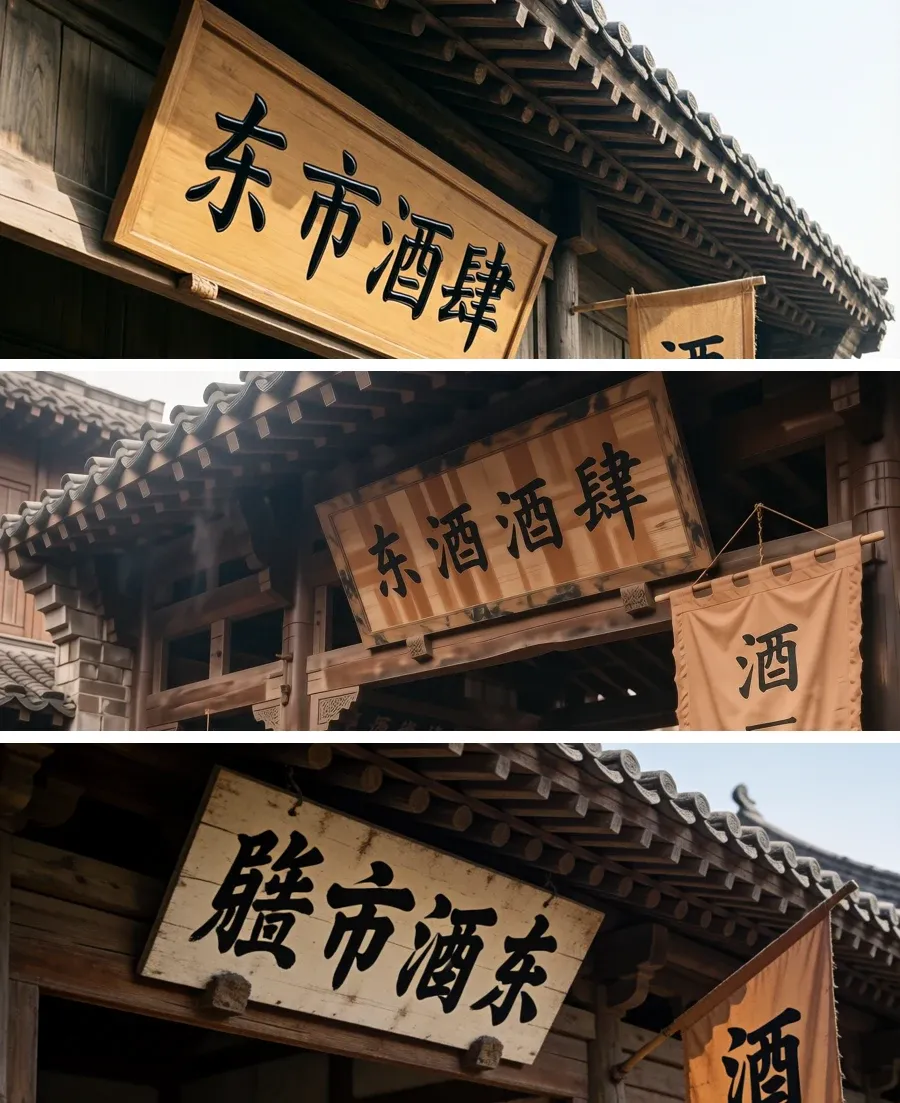
同一道题的三家。上:东市酒肆,一字不差。中:第二个字写成了酒。下:四个字全乱,第一个字还是个生造的字。这一条没有解释空间,字对就是对。
一次自我更正:塌的不是复合度,是断代形制
第四轮我做了个诊断:三道题各只留一层,把其余全剥掉,只留材质、只留光影、只留人物质感。
结果材质层和人物质感层都站得住:三种材质各自可辨,锈层有厚薄、陶断口有气孔、麻布经纬可数;人像那道十家全员没有塑料感和蜡像感,毛孔、细纹、日晒肤色不均、须茬都在。
我当时下的结论是:单层站得住、复合才塌,所以拆分工序有希望。
第五轮我专门出了道题去压这个结论——战国稷下学宫的辩论,三层空间、二十人以上且姿态不能重复、殿内暖火光与门外冷暮色要在地面形成可辨过渡,复合度远高于第一轮那道崩掉的商代宗庙。
结果它没崩。多数格拿到了正确的三层遮挡、二十人的场面、冷暖过渡。
所以我上一轮的诊断下早了。回头看第一轮那道商代宗庙的失败项,丝绸还是麻、石砌还是夯土、宫灯还是灯树、有没有桌椅,全是断代项,没有一项是人太多画不下。稷下学宫那道我只写了交领右衽、无桌椅这一点点形制约束,它就没崩。
塌的不是复合度,是精确到形制的历史还原。
然后是这次真正的发现
前面那些客观判据,我做得挺得意的:全是二元的,没有解释空间。匾上四个字对不对、左眉那道疤四格在不在、三格是横排还是竖排、无限手套几颗宝石。写成脚本能核,别人能复现。
四轮判下来,它们跟我的审美判定几乎不相关。
| 客观判据说 | 我看图说 | |
|---|---|---|
| 一家 | 版面四条全中、唯一带上特征锚点的两家之一、光影四条全中、表情演出最好 | 三轮都判不行 |
| 另一家 | 格数就错、材质做得糊、投影方向反了、画风前后不统一 | 两轮进前三 |
题材从中国古代换到漫剧、换到科幻魔幻,这个错位一次都没变过。
我量的是遵从度,模型有没有照着我说的做;我看的是别的东西。这两件事几乎正交。
这也就是前面那条没解释的矛盾的答案。那家盲测被圈中最多次、粗筛整屏却被我划掉的模型,在客观分上一直难看,却两轮被我的眼睛排进前三。它不是矛盾,是我的判据选错了对象。
所以这条改成了纪律
客观核只许用来削掉硬失败:被安全过滤器拦的、满屏噪点的、中文失效输出二次元少女的、格数完全跑偏的。这一层它准得很,一轮就帮我省掉七分之二的看图量。
客观核不许用来预排名,也不许拿它砍模型。这一轮如果按客观分砍,会正好砍掉我自己排第二的那家,留下我判不行的两家。
结论:没有一家到想发,但有一档凑活着可用
五轮、255 张、四次判定,题材换遍了中国古代、AI 漫剧、单层材质光影、科幻魔幻 IP。
没有一家本地开源到得了想发那条线。中国古代那个维度尤其明确,我看得上的只有云端那家。
我一度以为会分叉,科幻魔幻这种题材本地可能够用。追问自己之后否掉了,那一轮的判词是没到想发的程度,也是凑活着可用。
但凑活着可用不是不能用,它划出了一个真实的位置。这是五轮里唯一的正面结论:
| 用途 | 用谁 |
|---|---|
| 定稿 / 成片 | 云端那家 |
| 草稿 / 预览 / 试构图 / 铺量 | 本地 |
价值在省钱:试构图、试景别、试排版这类要反复抽卡的活占用量最大,每张都走云端是纯浪费,本地这一档正好接得住。
分界线得守住:凡是会进成片的画面,一律走云端。 把凑活着可用的东西放进成片,就等于放弃了想不想发这条判据,而那是我唯一的判据。
两次否定,其实是同一件事
第一次是测法错了:单 seed、不盲测、单张打分、题目太少。那次好修,照业界返工就行。
第二次是判据错了:我把能不能自动核当成了值不值得测。二元、可复现、能写成脚本,这些优点让我误以为它们在衡量重要的东西。它们衡量的是模型听不听话,不是图好不好。
这条对任何做评测的人可能都成立:你能测的东西,和你真正在乎的东西,中间那道缝有多宽,得自己去量一次才知道。
而量的办法只有一个笨办法,两套结论都留着,然后看它们对不对得上。我这次留了,所以看见了。
如果你也要做这类对比测试,上面那四个硬伤、四个坑、和最后这道缝,够你少走几天。