同一块卡上,我把两个视频模型摆在一起
目录 · 11 节
上周我写过一句话:LTX 比 H3 快 8.5 倍。
那句话被我作废了,因为两个模型跑在两块不同的卡上。这次把 H3 装到 LTX 那台机器上,重新测了一遍。
这两条本地视频线是 MiniMax H3 和 LTX-2.5,都是一次前向同时出画面和立体声,都在自己租的卡上跑。
先把这篇的边界划清楚
这不是评测,是一个人、一台卡、一天、二十几块钱能做出来的东西。它的局限得先摆出来,否则后面每个数字都会被读得比它该有的分量重。
每边 4 条样本,单一题材(雨前渡口的定场与氛围),单一画布(1344×768),两个时长(5 秒和 15 秒)。所有判词都是我一个人的审美,没有第二个人复核,没有量表,只有一句想不想发。比的是两套官方默认配置,不是同等采样预算:H3 是单段 20 步,LTX 是蒸馏版 8+3 步、而且第一段还在半分辨率上采样,谁多花了算力这个对比里没控。没测的有参考图锁角色、动作戏、15 秒以上的多镜、中英以外的语言、把参数往上调一档之后会怎样。
所以这篇不发奖状。它只记两件事:这两个模型各自是什么性格,以及我这套测法在哪些地方靠不住。
一、为什么上周那句话作废了
上周那个对比,我控住了画布、时长、帧数、采样器、随机种子,唯独没控硬件。H3 那条在 RTX 5090 上,LTX 那条在 RTX PRO 6000 上。
两块卡差多少?H3 换到 6000 上快 1.36 到 1.60 倍。8.5 倍里混着这一截,分不开。
所以补法只有一个:把 H3 装到 LTX 那台机器上。官方那套权重 39.6 GB,从魔搭下了 55 分钟,装完跑基线一次过。两个模型从此在同一块卡、同一个 ComfyUI 0.32.0 里。
二、同一块卡上,差距是 11.85 倍
1344×768、15 秒、两边都不挂加速开关、都确认过没吃到节点缓存:
| 冷跑(含权重读盘) | 热跑 | 一条的卡钱 | |
|---|---|---|---|
| MiniMax H3(362 帧) | 1200.34 秒 | 1164.74 秒 | ¥1.93 |
| LTX-2.5(361 帧) | 134.7 秒 | 98.30 秒 | ¥0.16 |
20 分钟一条,对 100 秒一条。
这个数比上周那个 8.5 倍更大,方向也没变,但它的意思和上周完全不同。上周是模型差异加硬件差异混在一起,这次只剩模型差异,以及那两套不同的官方默认配置。所以它回答的不是同样的活谁干得快,而是两家出厂设定跑一条 15 秒片各要多久。
顺带一个我没想到的对称:冷加载几乎一样。H3 的四件套 39.6 GB 读盘 35.6 秒,LTX 的六件套 50 GB 读盘 33.7 秒。这一项和画布、时长都无关,只和权重大小有关。
三、画质:四条都想发,我分不出
题目是新写的,两边都没跑过:暴雨将至的旧渡口,一个渡工把橙色缆绳系上锈铁桩。选它是因为它同时压三处,湿混凝土和锈铁的材质反光、风与水拍台阶的声音层、缆绳与铁桩的空间关系。
有一处我特意没做成同一串字喂两边:两边各按各家的官方 prompt 规范写。LTX 那份是官方改写器的 system prompt 要求的一整段散文,每一镜把景别、运镜、机位写齐;H3 那份是官方仓库要求的三段标注格式,画面时间轴、整体音景、非画内音乐。内容逐项对齐,措辞各按各家。拿同一串字喂两个规范不同的模型,看着公平,实际是在罚那个规范更严的。
四条片打乱编号发出去,我判完才揭底。判词是:四条都想发,分不出高低。
上:MiniMax H3。1344×768、5 秒、原生 32 kHz 立体声。
上:LTX-2.5。同一个题目、同样的画布和时长、48 kHz 立体声。
然后我想再往前一步,结果泄了自己的底
分不出高低之后,我心里其实有个印象觉得某一边稍好一点。为了验证这个印象是不是先入之见,我又跑了一轮:每边 4 抽、编号重洗、只问挑出更好的那几格、不问是谁。
挑出来的四条确实全落在同一组。八选四全中同一组,随机概率约 1.4%。
但这一轮不算干净的盲测,漏洞是我自己造成的。第一轮揭底时,我把两边的规格表一起发了出去,一边是 124 帧 / 5.17 秒 / 32 kHz,另一边是 121 帧 / 5.04 秒 / 48 kHz。播放器上时长是看得见的。 也就是说,第二轮理论上可以靠时长反推出分组。
更麻烦的是后来还冒出第三条泄漏通道:两边的声场宽度差 3 到 10 倍,左右声道平均差上 H3 那边明显更宽。前两条能靠统一转码抹掉,这一条抹不掉,它是内容属性,不是容器属性。
所以这一格我能报的只有第一句:四条都想发。至于谁更好,我这套测法给不出可信答案——n=4、单一题材、一个人的审美、盲态还有泄漏。真要回答,得静音判画质、换新素材、统一转码,最好再换个人来判。
四、对白:口型两边都对得上,差别在声音的性格
台词八个字,“船不来了,回去吧。”,画面同一个渡工、同机位、同随机种子。中文一组、英文一组(“The boat is not coming. Go on home.”),只换语言,别的不动。
判词是:中英文、两个模型,口型都对得上。
上:MiniMax H3,中文台词。
上:LTX-2.5,同一句中文台词。
能听出来的差别不在口型,在声音的性格。H3 是明显的立体音效,声场铺得开;LTX 更接近真实,像现场收的。这两条不构成高低,是两种取向。
它有个能量出来的客观对应物。我把当天全部产物的左右声道平均差扫了一遍:
| 环境声那组 | 中文对白 | 英文对白 | |
|---|---|---|---|
| MiniMax H3(32 kHz) | 0.0093 · 0.0103 | 0.0224 · 0.0101 | 0.0068 · 0.0063 |
| LTX-2.5(48 kHz) | 0.0039 · 0.0049 | 0.0017 · 0.0022 | 0.0012 · 0.0010 |
H3 的左右分离度是 LTX 的 3 到 10 倍,LTX 那两轨接近单声道。注意采样率和声场是两回事:LTX 是 48 kHz,比 H3 的 32 kHz 高,声场却窄。别拿采样率当音质结论。
这一节我改过一次,值得说说为什么
第一遍看的时候我判的是中文这一格 H3 明显好,据此写下过一句差距在语言不在能力。再看一遍,改成了两边都对得上。
口型这种东西看一遍判不准,它要盯着嘴、要反复回看、要关掉画面之外的干扰。而我第一遍看的时候,两条片的声音差别很明显,就是上面那个声场,很容易把这条听着更像那么回事记成这条口型更好。
这也是这篇里所有判词的共同风险:一个人、看一遍、凭印象。前一节那个泄了自己的底是同一类问题的另一个面。
五、一个加速开关,四个不同的倍数
SageAttention 是个把注意力算子换成量化版本的开关,不改模型、不改步数。我在两台卡、两个模型上各测了一遍:
| RTX 5090(显存吃紧) | RTX PRO 6000(显存宽裕) | |
|---|---|---|
| MiniMax H3 | 2.35× | 1.65× |
| LTX-2.5 | 1.19× | 1.33× |
同一个开关,四个数,而且两行的方向是反的。
我在这个开关上连着推广错了三次,三次都是被另一组数打脸才发现的。我写过 Sage 值 2.35 倍,那是 H3 在 5090 上的数,同一个模型换台卡只有 1.65 倍。我写过序列越长 Sage 越值,那是 H3 的性质,LTX 上 5 秒和 15 秒都是 1.19 倍,一模一样。我还写过挂上之后产物会变成完全另一条片,那也是 H3 的观察,LTX 上挂不挂产物基本不变。
加速比不是模型属性,是模型乘机器乘档位的联合属性。 想知道值多少,只能一台一模型地实测。
顺带一条反直觉的:在 5090 上 Sage 省 3 到 5 GB 显存,在 6000 上反而多吃 2.9 GB。省显存本来就不是它的直接效果,是显存压力小了、换出少了的副产物;一张不吃紧的卡上,那个副产物就没有了。
画质那一格倒是两条线都判过,挂与不挂各一对、去掉音轨只看画面,判词都是看不出区别。但同样别跨线推广,在我另一条图片线上,同一个开关的判词是不挂反而稍好一点。
六、多镜:两种性格,不是谁行谁不行
这是差别最清楚的一格,也是最不像谁更强的一格。
同一段渡口,写成三镜 15 秒,切点写死在第 5 秒和第 10 秒,两边各按各家的官方切口写法。
H3 那边是按点切的。它的官方规范里有时间戳语法([Shot 2] At 00:05.000, the camera cuts to…),实测两刀落在 4.88 秒和 10.12 秒,误差 0.12 秒。
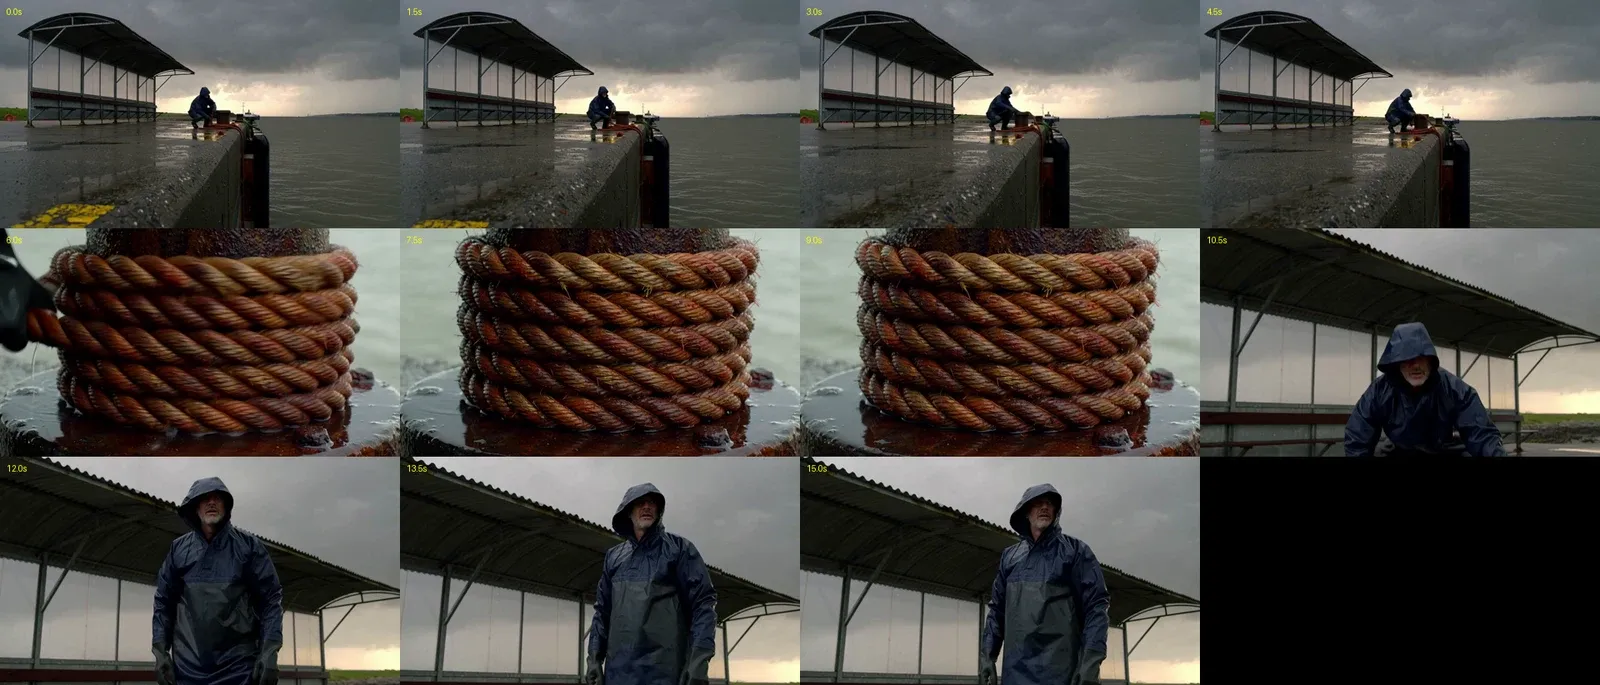
H3:定场、缆绳特写、人物中近景,两处切换都是硬切。
LTX 那边一刀没切。但它不是没换镜头,三个镜头的内容一个不少,只是转场被做成了溶接和推进。
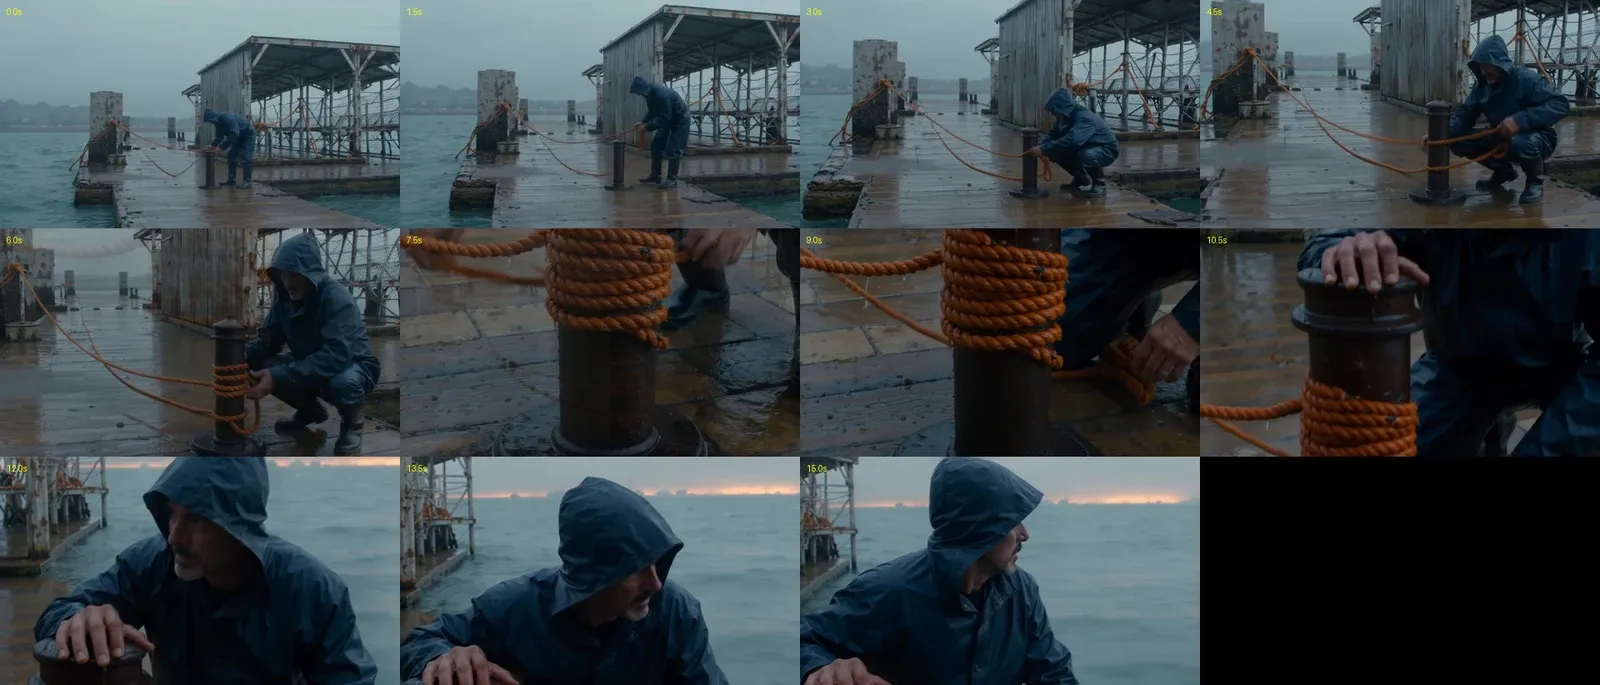
LTX:同样三个镜头都在,转场是软的。
到这儿也很容易写下 LTX 15 秒切不动。又是错的。我拿之前那条面馆题目在同一台机器、同一个进程、同样参数下重跑,它切出了两个干净的硬切。
真正的差别是:LTX 切不切取决于内容,H3 的时间戳跟内容无关。
我又拆了一层:把三镜里第二镜从同一根绳的特写(只变景别)换成空候船棚内景(主体和地点都变),别的一个字不动。
| 第二镜 | 两个种子各跑一条 |
|---|---|
| 只变景别 | 0 刀 / 0 刀 |
| 主体地点都换 | 1 刀 / 1 刀 |
方向坐实了:镜与镜之间只变景别,它就把硬切降级成运镜。这和 H3 官方规范里那句只需要改变景别或小角度时优先用运镜而不是切,是同一个倾向。
但复核同时炸出一件更要紧的事:两条都只给了一刀,而且哪一刀变硬还随种子变,一条硬在第 10 秒,另一条硬在第 5.5 秒。所以把内容拉开是必要条件,不是充分条件。LTX 的切是概率性的,H3 的切是确定性的。
七、这次没能回答的
画质到底谁好,见第三节,我的测法不支持这个结论。
参考图锁角色也没法比。H3 有多图全能参考,LTX 这条线我只有首帧图生视频,两边不是同一个能力,没法同题比。
动作戏两个我都单独判过,判词都是不行,这一格是空的,换模型补不上。
15 秒以上的多镜同样空着。LTX 已知 32 秒往上一刀不切;H3 的官方训练范围上限就是 15 秒,再长是官方明说没测过的区间,跑出来也不能当能力证据。
还有把参数往上调一档之后会怎样。全程官方默认,没调过步数、采样器、CFG。
八、所以选哪个
各有各的好,各有各的坏,最后是看你要什么。就我这一天测下来,两个的性格大概是这样:
| MiniMax H3 | LTX-2.5 | |
|---|---|---|
| 切点 | 写在哪一秒就切在哪一秒,误差 0.12 秒 | 切不切取决于内容,且哪一刀会硬随种子变 |
| 对白口型 | 中英文都对得上 | 中英文都对得上 |
| 声音 | 明显的立体音效,声场铺得开 | 更接近真实,像现场收的 |
| 速度与钱 | 15 秒一条 20 分钟 | 同一条 100 秒,便宜一个数量级 |
| 时长上限 | 官方训练范围到 15 秒 | 能跑到 41 秒,但多镜只在 15 秒内成立 |
要卡点、要对着分镜表做,H3 那套时间戳很难被替代;要成批出、要抽卡、要长一点的片,LTX 的成本结构是另一个量级。声音那一格是取向问题,要铺得开的立体声,还是要像现场收的。而如果你只是要一条五秒的氛围镜,我这四条片四条都想发,分不出高低。
还有一层是硬件。这两个模型我都各在两块卡上跑过,最便宜的组合都落在那张更小、更便宜的 5090 上,大卡快那 20% 到 60%,抵不过它 2.15 倍的时价。所以选哪个模型和租哪块卡得一起算,单看模型会选错。
最后把话说回开头:这是一个人、一天、二十几块钱的测试。样本小、题材单一、判词是我自己的审美,而且我在里面至少犯了三次把某个模型的性质当成通则的错,三次都是被另一组数打脸才发现的。你要是拿这两个模型做别的题材,结论完全可能反过来。真正能带走的大概只有一条:任何 A 比 B 快多少好多少的数字,都得先问清楚它是在哪块卡、哪个档位、哪种题材上量出来的。