我以为它挑格式,其实它只是嫌你说得太少
目录 · 8 节
官方仓库里有个文件叫 examples/t2i/data/u1_5_gallery.jsonl,是他们自己的示例 prompt。我点开,头几条全是 JSON。
于是我下了个结论:这个模型只吃结构化 JSON,不吃自然语言段落。
这个结论是错的,而且我是照着它改了一轮 prompt、看着效果确实变好之后才下的。花了五组对照实验才把它推翻。真正管用的东西一直摆在那儿,只是我看错了它是什么——不是格式,是你把需求写得多详尽。
SenseNova-U1.5-8B-MoT 是商汤 2026-08-19 开源的原生统一多模态模型,理解和生成共用一个权重,Apache-2.0。我在一张 RTX 5090(32G)上把它从装机跑到出图、编辑、多图参考,一共 13 发文生图、8 发编辑,零失败。稳态 46 秒一张(2720×1536,50 步),显存 17.4 GiB / 32 GiB。50 GB 的 bf16 权重靠官方自带的层 offload 塞进 32G 卡,输出和不 offload 时逐位相同。
装机:官方推荐的装法会毁掉你的机器
官方文档让你这么装:
comfy node install ComfyUI-SenseNova-U1别这么干。 sensenova-u1 的依赖里是硬 pin:
"torch==2.8.0",
"torchvision==0.23.0",
我这台机器上是 torch 2.12.1+cu130,上面还跑着另外六条产线:视频、音频、超分、另外三条出图线。这条命令会自动装依赖,把 torch 降级到 2.8.0,六条线一起陪葬。5090 是 Blackwell 架构,降级之后卡本身能不能用都难说。
官方在注释里其实承认了这是有意为之:Hardware-facing packages stay pinned to the reference inference environment。他们钉的是自己的参考环境,不是你的。
正确的装法是 --no-deps,然后手动补真正缺的包。我实际盘点下来只缺 accelerate 一个:
pip install --no-deps ./sensenova-u1.tar.gz
pip install "accelerate>=1.1,<2"
python -c "import torch;print(torch.__version__)"   # 确认没被动
装完 pip 会打印一串 requires torch==2.8.0, but you have 2.12.1+cu130 which is incompatible。这是预期的、正确的:声明冲突摆在那儿,但没有任何包被降级。看到这几行不要去动它。
顺带一个坑:
pip install直接吃 GitHub tarball URL 会中途断(ProtocolError: Connection broken),237 MB 拉不完。改成 aria2c 先落盘、gzip -t验完整、再从本地文件装。
我是怎么得出那个错结论的
回到开头那个 jsonl。我点开看到的头几条长这样:
{"type": "概念插画海报 / 纸雕风格视觉海报",
 "canvas": {"aspect_ratio": "2:3", "safe_margin": "……"},
 "main_subject": {"subject": "……", "position": "……", "pose_or_action": "……"},
 "composition_layout": {"overall_structure": "……", "leading_lines": "……"},
 "lighting": {"key_light": "……"}}
官方把这套流程叫 Image PE(Prompt Enhancement),文档里的措辞是强烈推荐作为推理前的默认步骤。benchmark 也对得上:QwenImageBench 带 PE 60.2 分、不带 52.63 分,差 14%。
我于是把自己 prompt 里的描述挪进 JSON 字段,效果立竿见影。一条要求 细长的龙身呈优雅的 S 形曲线 的龙,段落版出来近乎笔直,挪进 pose_or_action 之后 S 形就出来了。一个唐代西域胡商,段落版连出三发东亚脸,连补一句“明确不是东亚面孔”都没用,挪进 appearance 字段一次就对。
证据链看起来完整了,我就下了结论。这里有两个错。
第一个错在那个 14%,它比的根本不是格式。我去翻了官方 PE 对比里“不带 PE”那一侧的输入原文,它长这样:
Create a vertical independent book-fair poster.
Exact copy: "PAPER TRAIL", "7 NOV", "CENTRAL LIBRARY". Add no other text.
就这一句话。而 PE 之后的输出,官方在脚本里写死了目标:Target 1,100–1,500 output tokens。所以那 14% 比的是一句话和扩写成一千多 token 的详尽描述,不是段落和 JSON。我把有没有做 prompt 增强,读成了格式之差。
第二个错更直接:官方合同自己就要求写自然语言。src/sensenova_u1_5/image_pe.py 里那句 Use the exact JSON shape below 后面跟的 schema,有一格是这样的:
"image_description": "a complete natural-language description
                      that integrates the scene without repeating every field"
官方规定的 JSON 里,必须有一段完整的自然语言描述。 同一段还写着 Describe finished pixels with specific, cohesive prose,字段里要写散文,不是填关键词。一个只吃 JSON、不吃自然语言的模型,它的官方合同不会长这样。
顺带纠正我自己的另一处。我说官方 gallery 每一条都是 JSON,这句话在两个层面上都不准。一是不是每一条,我只看了前三条,六条里有一条是纯自然语言段落,2527 字,还是六条里最短的,照样进了官方展示。二是那五条严格说也不是 JSON,是 Python 的 repr,单引号,json.loads 解不开,得用 ast.literal_eval。
那就做个对照:同样的内容,只换格式
要把写得详尽和写成 JSON 这两个变量分开,办法很直接:拿官方自己的 JSON,把结构拆掉,内容一个字不改。
我写了个脚本做机械降级,递归取出 JSON 里所有的值,按原顺序拼成一段话,只丢掉键名和层级。6097 字的 JSON 变成 4099 字的段落,159 个字段值一个不少。gallery 里 5 条 JSON 全做一遍,每条两版同 seed 42、同官方推荐分辨率各跑一发。
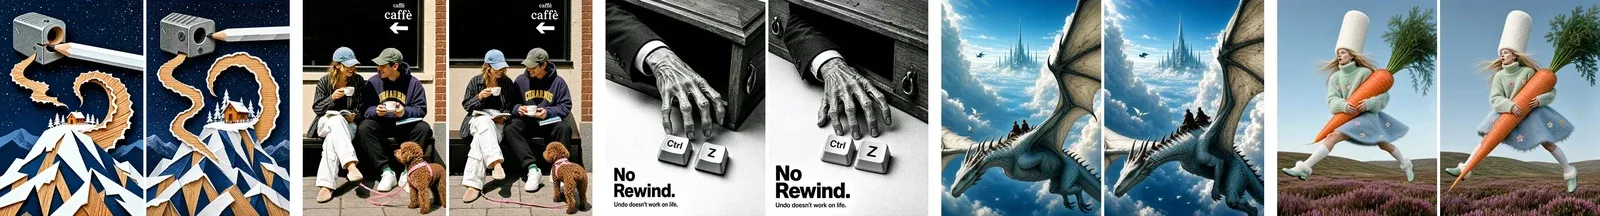
五组,每组左=降级成段落,右=官方原始 JSON。咖啡馆情侣、Ctrl+Z 海报、飞龙云海、胡萝卜时装这四组,我看不出有意义的差别,画面里的英文字两版也都渲染正确。
四组肉眼无差别。 只有第五组纸雕雪山有一处稳定差异,落在空间关系上:官方要求 中心小屋和环形木屑山峰位于安全区域内,JSON 版把小屋抱在木屑环的正中心,降级版的小屋缩小了并且跑到了环外面。
所以我现在的说法是:
格式的独立贡献很小,主要体现在空间关系上。真正决定质量的是写得多详尽。
这个结论也有边界,我不想再犯同一个错:五组题目、单 seed、我一个人看、非盲测。它足够推翻只吃 JSON 这个强断言,但不足以反过来断言格式完全无关。
那我前面那条龙、那张脸怎么解释?我自己写的 prompt 远没有官方那么详尽。官方那条有 159 个字段值,我那条只有二十几项要求挤在两百字里。信息本来就不够,结构一丢就更接不住。所以那两次的提升,很可能大部分来自挪进字段时我把话说得更清楚了,而不是 JSON 这个格式。
还有一处我做错了。官方 PE 明确写着 do not restate the same detail across fields,禁止跨字段重复;而我为了保险,把 S 形写进了四个字段。所以那次实验里,结构和重复强调根本就没分开。
JSON 拉得动要什么,拉不动不要什么
这是同一批实验里的第二个发现,而且是个反例。
我在 JSON 里放了一个 constraints.forbidden 数组,里面明写了 任何人物。结果四格画面全是行人,比自然语言版还明显。而 腰间不系腰带、无任何配饰 这条,我是写在 distinctive_details 里的,正面描述的形式,它执行了。
规律很清楚:把禁令改写成正面描述。
别写:不得出现任何人物
改写成:街道空无一人,只有摊位和空荡的石板路
这条对所有出图模型大概都成立,只是这次有了个干净的对照。
另一件事:我把编辑测坏了,然后花了八发才找到原因
出图跑通之后我去测图像编辑,那是这个模型对我真正不可替代的能力:Apache-2.0,跑在自己卡上。
结果连挂五发。失败的样子很有辨识度,输出变成高对比度的版画或线稿,写实照片的质感被整体重绘,84~86% 的像素被改,而且编辑指令本身经常没执行——我让它把一辆翻倒的邮车扶正,车还是翻的。
我依次调了这些:img_cfg_scale 从 1.0 提到 2.0,反而更差;vram_mode 从 fast 换成 balanced,输出逐位相同;中文 prompt 换成英文,一样坏;编辑指令从改光换成扶正一个物件,一样坏;prompt 从简略换成逐项列出要保留什么,还是一样坏。

八发编辑各改动了多少像素。前五发在参数上打转,数字纹丝不动地卡在 84% 一线;换成官方输入立刻掉到 11.2%,把自己的图裁成 16:9 之后是 36.5%(改光会牵动大片区域,这个值是正常的)。
五发全是白费。真正有效的一步,是先确认这不是模型的问题:官方 Space 上的示例编辑是好的,所以我把官方那张示例图和官方那条英文 prompt 原样搬到本地,跑了一遍。
正常。11.2% 的像素变化,夹克变黄,人脸、姿势、背景纹丝不动。
问题在我这边。接下来是四步二分,每步只动一个变量:
| # | 实验 | 改动像素 | 结论 |
|---|---|---|---|
| 1 | 官方图(672×1024,2:3)+ 官方 prompt | 11.2% | 正常,排除环境问题 |
| 2 | 我的图缩到同样像素数(仍是 2:1) | 84.6% | 仍坏,排除尺寸问题 |
| 3 | 官方图 + 我那条改光指令 | 71.8% | 正常,排除指令类型 |
| 4 | 我的图裁成 16:9,其余全同 | 36.5% | 正常,根因就是宽高比 |
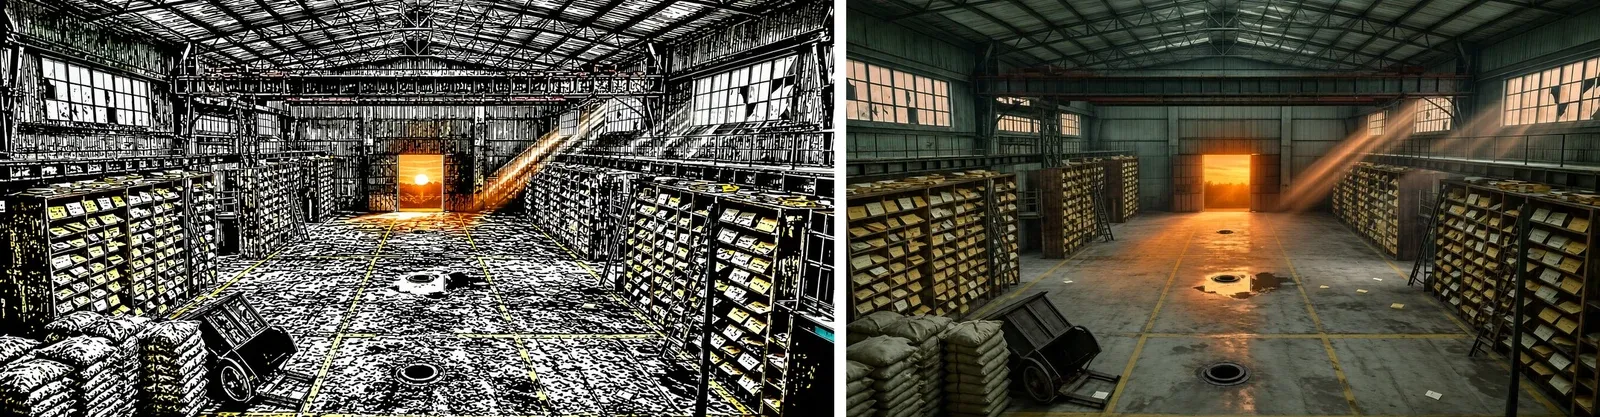
同一张图、同一条 prompt。左:输入是 2:1,整张崩成版画。右:把输入裁成 16:9,门外变成黄昏暖阳,而格架、信封、邮袋堆、翻倒的邮车、地面黄线、积水、光柱全部保持不动。
根因是输入图的宽高比 2:1 太极端。 出图阶段用 2:1 完全没问题,官方档位表里就有 2880×1440,只有编辑路径对极端比例敏感。要 2:1 的成品,就先按 16:9 编辑,再裁。
这件事真正的教训不是 2:1 不行,而是排查顺序。我在参数上瞎调了五发,而第一步就该做的是拿官方的输入跑官方的例子——那一发直接把模型的问题和我的问题切开了。
一个我差点当成功案例写进来的坑
最后要测的是多图参考。我用官方仓库里的三图融合案例,prompt 一字未改:把第一张图的橘猫放到第二张图的复古玩具车上,再把这一组放进第三张图的咖啡馆。ComfyUI 里三张图要合成一个 batch 才能喂给编辑节点,我串了两个 ImageBatch 接上去。
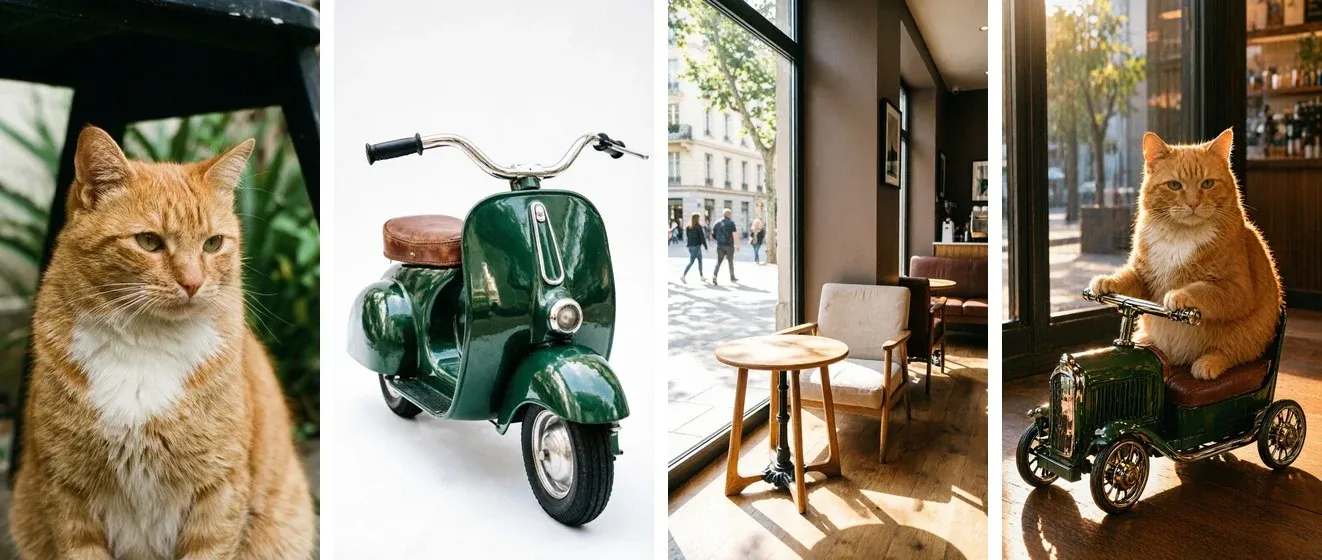
左三张是输入,最右是结果。
46 秒出图,猫的绿眼睛和胸前那块倒三角白毛都保住了,咖啡馆的金色逆光和地板投影也在。唯一不对的是车:第二张图那台是 Vespa 式的踏板摩托,结果画成了一台老爷车。
我当时的解释是,它对有生命的主体更看重,对器物形制就松得多。这个解释是编的。
真相是另一个人查出来的:官方的 ComfyUI 节点只吃第一张图。
# image_utils.py:90-93
if array.ndim == 4:
    array = array[0]          # ← 批里只取第 0 张
也就是说,我那三张图里只有橘猫进了模型。玩具车和咖啡馆一个像素都没被读到,那台老爷车是模型光看着文字描述画出来的,难怪不像。
而且这条是拿实验坐实的,不是只读源码。同 seed、同 prompt,一次喂一张图,一次喂 ImageBatch[A, 一张纯红底大白圆],两次产物逐像素完全相同,mean diff 0.0000。第二张图确实一个像素都没影响到结果。
这里还藏着一个判据陷阱:拿字节比会得出相反结论。ComfyUI 的 SaveImage 会把整个 workflow 塞进 PNG 的文本块,两次的 workflow 不同,所以字节必然不同。要比就比像素。
模型本身是支持多图的,上游推理函数第三个参数收的就是图片列表,官方 Space 还为它设了最多 4 张、总像素不超过 2048² 的限制。卡住的是官方没把这条路接到 ComfyUI 上。
这件事让我把前面那个“猫保住了车没保住”的观察整个撤回。一个我没验证过的机制,被我拿来解释一个我没核实过的现象,最后编出了一条听起来很有道理的规律。
数字
| 权重 | bf16 50.2 GB(13 个分片,编号跳号,没有 00002~00004) |
| 参数 | 总量约 25B。名字里的 8B 指的是里面 LLM 那一半,MoT 是理解和生成两座塔 |
| 显存 | vram_mode=fast,峰值 17.4 GiB / 32 GiB |
| 速度 | 稳态 46 秒/发(2720×1536,50 步)。首发 146.8 秒,多出来的是一次性加载 |
| 参考 | 同规格在 ZeroGPU(H200)上约 70 秒 |
| 出图档位 | 1:1 = 2048² · 16:9 = 2720×1536 · 最高 3456×1152 |
| 官方参数 | cfg_scale 4.0 · timestep_shift 3.0 · num_steps 50 |
关于层 offload 有个意外收获:fast 和 balanced 两种模式的输出逐位相同。也就是说这套 offload 是无损的,50 GB 塞进 32 GB 卡不用付画质的代价,只付时间。
值不值得用
画质上,它在我这儿的位置是:比手上那几条本地开源都强,但没到我想发的程度。出定稿还是得用云端那条线,它的位置是接住草稿、试构图、铺量那一档——那是量最大、最费抽卡的一块。
但真正让我改变看法的不是画质,是它对精细指令的响应能力此前被我低估了。S 形、族裔、袖长、腰带,我一度都记成了模型固有短板,实际全是我 prompt 写得不够。
所以这篇如果只留一句:接一个新出图模型之前,先去它的官方仓库里翻一眼示例 prompt 长什么样。 不是翻文档里的说明文字,是翻它喂给模型的那份数据。
我上一次栽在这上面是 Ideogram 4,那次也是裸自然语言通过率 12.5%,挂上官方 JSON 转换器之后 93.8%。两次都是同一个形状的坑,两次我都是先跑了一堆实验,才回头去看官方到底怎么喂的。
第三次希望能先看。